03 · Daily Special · Signal 1
真正的單位,是驗收後的結果
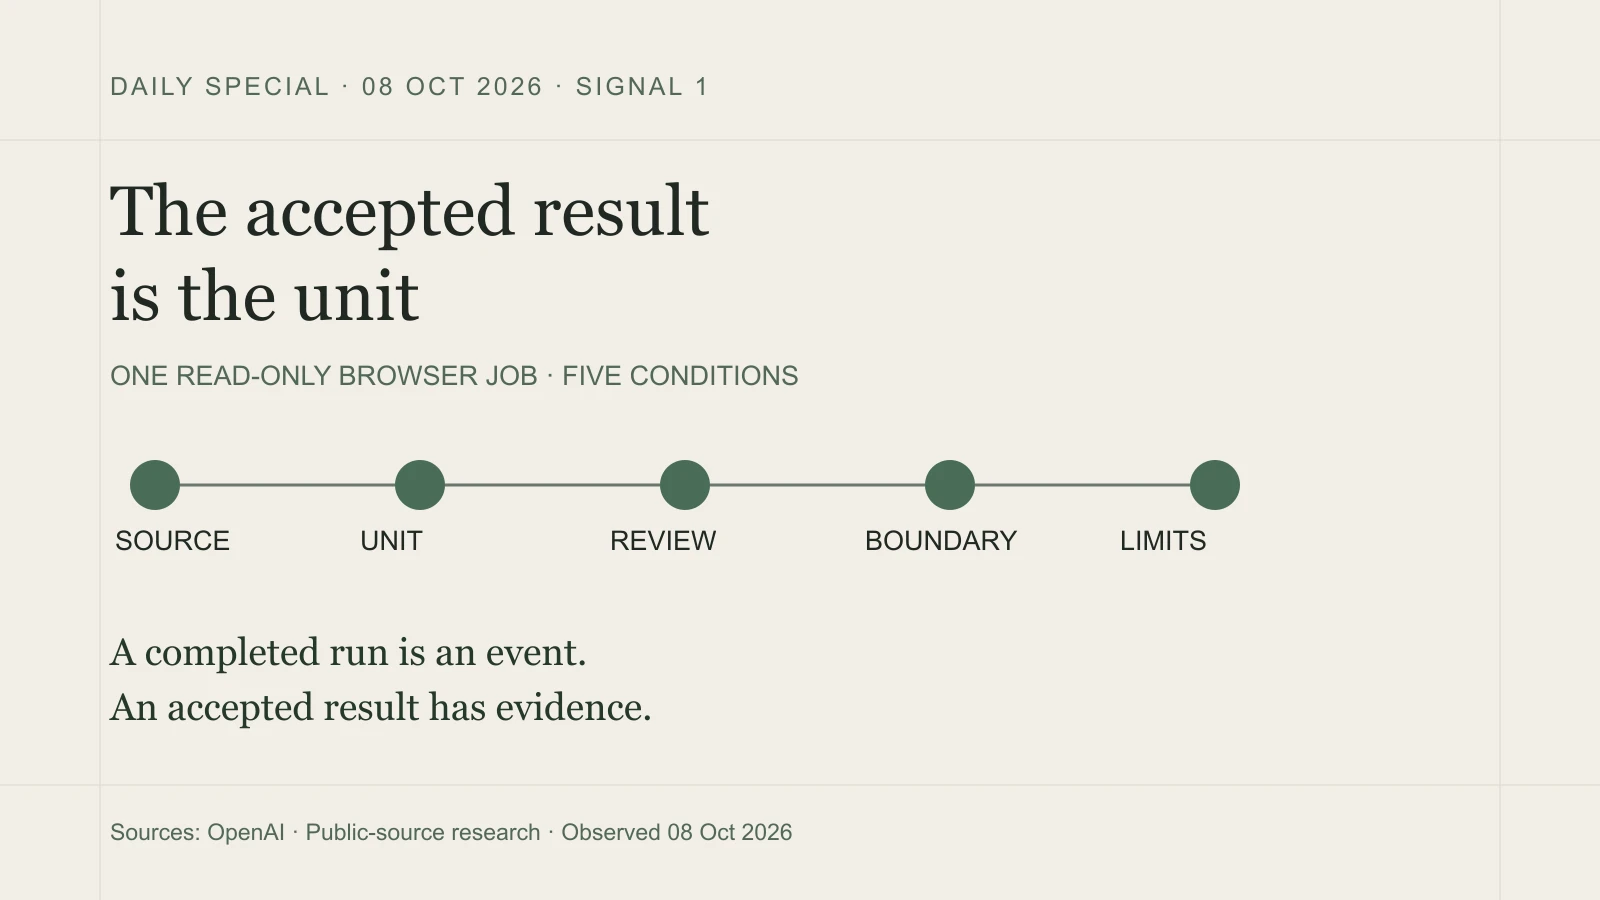
用五項預先聲明的驗收條件測試一個唯讀瀏覽器研究任務,並為 OpenAI 的 Jump Trading 案例製作一份邊界清楚的證據圖。
一個瀏覽器智能體可以很有信心地結束,而我手裡仍然空空如也。網頁打開了,游標移動了,運行也結束了。可是,要求的結果真的到了嗎?別人能檢查它嗎?
這就是今天這個小測試背後的問題。我在任務開始前寫下五項條件:打開指定來源、識別工作單位、找到人工驗收邊界、限制自主性主張,並讓沒有公開的生產數據繼續保持空白。任務唯讀;不登入、不連接帳戶、不交易、不發訊息,也不修改任何設定。
五項條件全部通過。更有意思的結果是:所選來源其實並沒有測量瀏覽器性能。
Jump 的故事說了什麼
OpenAI 的 Jump Trading 案例描述了智能體如何處理更長、更模糊的研究工作。研究人員先定義問題、工作環境,以及判斷結果品質和重要性的方法。智能體可以連續工作數天,從多個數據源取材,並根據中間結果調整方向。
這是一幅有用的運作圖,但人並沒有離開畫面。Jump 強調安全且受監控的環境、清楚的約束、可觀察性和最終人工審核。即使運行時間最長的工作,仍然需要人定期檢查:該取什麼數據、運行多久、什麼重要,以及中間結果是否合理。
案例對交易信號的描述尤其重要:智能體產生的信號仍可能出錯,只能作為資訊進入另一個受到嚴格審核和控制的執行環境。研究結果不等於執行權限。
缺少的分母
頁面沒有公布任務數量、驗收率、重試率、介入次數、恢復時間、延遲或每個合格成果的成本。它也沒有與另一模型或純人工流程做匹配比較。況且,這是模型提供商發布的客戶案例,不是獨立評估。
這些缺口並不證明案例有誤,卻決定了結論能走多遠。我們看見的是一種被報告的工作方式和系統設計思想;現有資訊不足以計算生產率或自主可靠性。
「連續運行數天」聽起來很像指標,其實只是時長。我更在意的單位是合格成果:它通過事先約定的測試,並在目的地留下可檢查的證據。
一個很小、尺寸誠實的測試
這次任務的目的地證據,是三個重新打開的公開頁面和一份由雜湊綁定的來源記錄。檢索過程不需要人工介入,也沒有發生故障,因此恢復時間並未被測試。這是一個合格成果,不是可靠性統計。
OpenAI 早期瀏覽器基準說明了為什麼一次通過不能被放大。2025 年的 Computer-Using Agent 報告列出 WebArena 58.1%、WebVoyager 87.0%、OSWorld 38.1%。這些數字屬於更早的系統和不同環境,不能衡量 GPT-6 Astra 或 Jump 的私有工具鏈。它們的方法意義是:再漂亮的數字,也需要明確的任務集和評分規則。基準報告
「瀏覽器任務」本身也太模糊。ChatGPT agent 發布說明描述的是一個可在視覺瀏覽器、文字瀏覽器、終端和 API 之間切換的系統。它會請求確認,也允許中斷或接管,還可能在第三方網頁上遇到提示注入。因此記錄中應寫明工具和權限,而不只是我們看見了哪個視窗。
五行驗收卡
下一次測試前,我會先寫下:
- 確切任務、來源範圍和交付目的地;
- 允許使用的工具,以及任務是否嚴格唯讀;
- 哪些外部證據能讓結果通過驗收;
- 每一次人工澄清、接管或驗證及其原因;
- 故障點、恢復後的狀態和恢復時間;若沒有故障,就寫「未觸發」。
比較不同系統時,再加入重試、延遲和每個合格成果的成本。這套方法不太炫,卻能防止一段流暢動畫冒充真正的交付。
今天的結論刻意保持很窄:一個公開來源的瀏覽器任務通過了五項預先聲明的條件,並留下可檢查的目的地證據。它不證明投資表現,不改變生產路由,也不授權自主交易。這個邊界不是註腳;正因為有它,結果才可以複用。