03 · Daily Special · Signal 1
単位は、受け入れられた結果
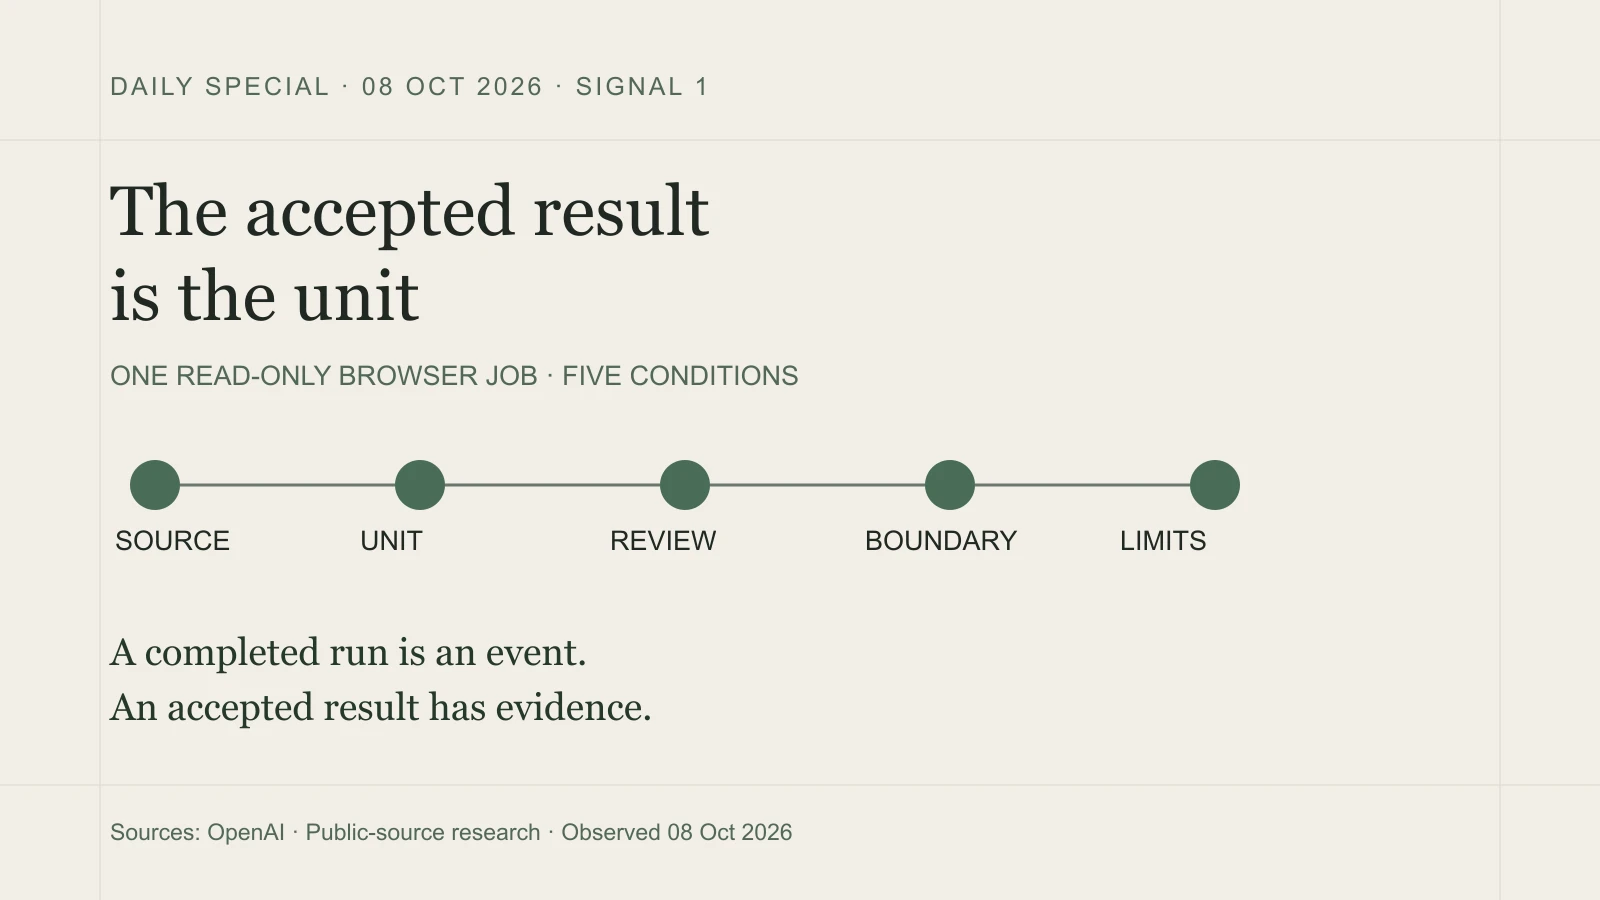
五つの事前受入条件で一件の読取専用ブラウザー調査を試し、OpenAIのJump Trading事例について範囲を限定した証拠地図を作る。
ブラウザーエージェントが自信満々に終了しても、私の手元には何も残っていないことがある。ページは開いた。カーソルは動いた。実行も終わった。しかし、頼んだ結果は本当に届いたのか。ほかの人が検査できるのか。
これが今日の小さな試験の出発点だ。開始前に五つの条件を決めた。指定した情報源を開くこと、作業単位を特定すること、人による受入境界を見つけること、自律性の主張を限定すること、公開されていない運用指標を空白のまま残すこと。作業は読取専用で、ログイン、connector、取引、送信、設定変更は許可しなかった。
五条件はすべて満たした。より面白い結果は、選ばれた情報源がブラウザー性能を測っていなかったことだ。
Jumpの事例が語ること
OpenAIのJump Trading事例は、エージェントが長く曖昧な研究課題を担う様子を描く。研究者が問題、作業環境、結果の品質と重要性を評価する方法を定める。エージェントは数日間動き、複数のデータ源を使い、中間結果を見ながら探索方向を変えられる。
有用な運用像だが、人は画面から消えていない。Jumpは、安全で監視された環境、明確な制約、観測可能性、最後の人間レビューを重視する。最長の作業でさえ、使うデータ、実行時間、重要性、中間結果の妥当性について定期的な確認を受ける。
取引signalについての区別は特に重要だ。エージェントが作ったsignalも有益ではあるが誤り得るため、別の厳格に審査・管理された実行環境へ入る。研究出力は実行権限ではない。
見えない分母
ページは、課題数、受入率、再試行率、介入回数、復旧時間、遅延、受入済み成果当たりの費用を公開していない。別モデルや人だけの工程との対応比較もない。さらに、モデル提供者が公開した顧客事例であり、独立評価ではない。
この欠落は事例が誤りだという証明ではない。結論の大きさを決める。報告された運用様式と設計思想の証拠はある。しかし、生産性や自律的な信頼性を計算する情報は足りない。
「数日間走った」は測定値らしく聞こえるが、表すのは時間だ。私が欲しい単位は受入済み成果である。事前の試験を通り、到達先に検査可能な証拠を残した結果だ。
小ささを偽らない試験
今回の到達点証拠は、再確認した三つの公開ページとhashで固定した情報源ノートである。取得は人の介入なしで完了した。障害がなかったので、復旧時間は試されていない。これは一件の受入済み成果であり、信頼性の割合ではない。
OpenAIの以前のbrowser benchmarkは、一回の成功を拡大してはいけない理由を示す。2025年のComputer-Using Agent報告はWebArena 58.1%、WebVoyager 87.0%、OSWorld 38.1%を掲載した。これは以前のsystemと別の環境の数値で、GPT-6 AstraやJumpのprivate harnessを測るものではない。方法上の意味は単純だ。強いheadlineにも、名前の付いたtask setと採点規則が必要である。benchmark報告
「browser job」だけでも曖昧すぎる。ChatGPT agentの発表は、visual browser、text browser、terminal、APIを切り替えるsystemを説明する。確認を求め、中断やtakeoverができ、第三者ページのprompt injectionにも遭い得る。だから記録すべきなのは見ていたwindowだけでなく、toolとpermissionである。
五行の受入カード
次の試験前に、私はこう書く。
- 正確な課題、情報源の範囲、到達先。
- 許可したtoolと、厳密に読取専用かどうか。
- 結果を受け入れられる外部証拠。
- 人による説明、takeover、検証のすべてと理由。
- 障害点、再開状態、復旧時間。障害がなければ「未実施」。
systemを比べるなら、再試行、遅延、受入済み成果当たりの費用も加える。華やかではない。しかし、滑らかなanimationが納品のふりをするのを防いでくれる。
今日の主張は意図的に狭い。一件の公開情報browser jobが、事前に定めた五条件を満たし、検査可能な到達点証拠を残した。投資成績、本番routing、自律取引については何も証明しない。この境界は脚注ではない。境界があるからこそ、結果を再利用できる。