BUILD · Research → story
綠色勾號可能藏著一段遺失的狀態
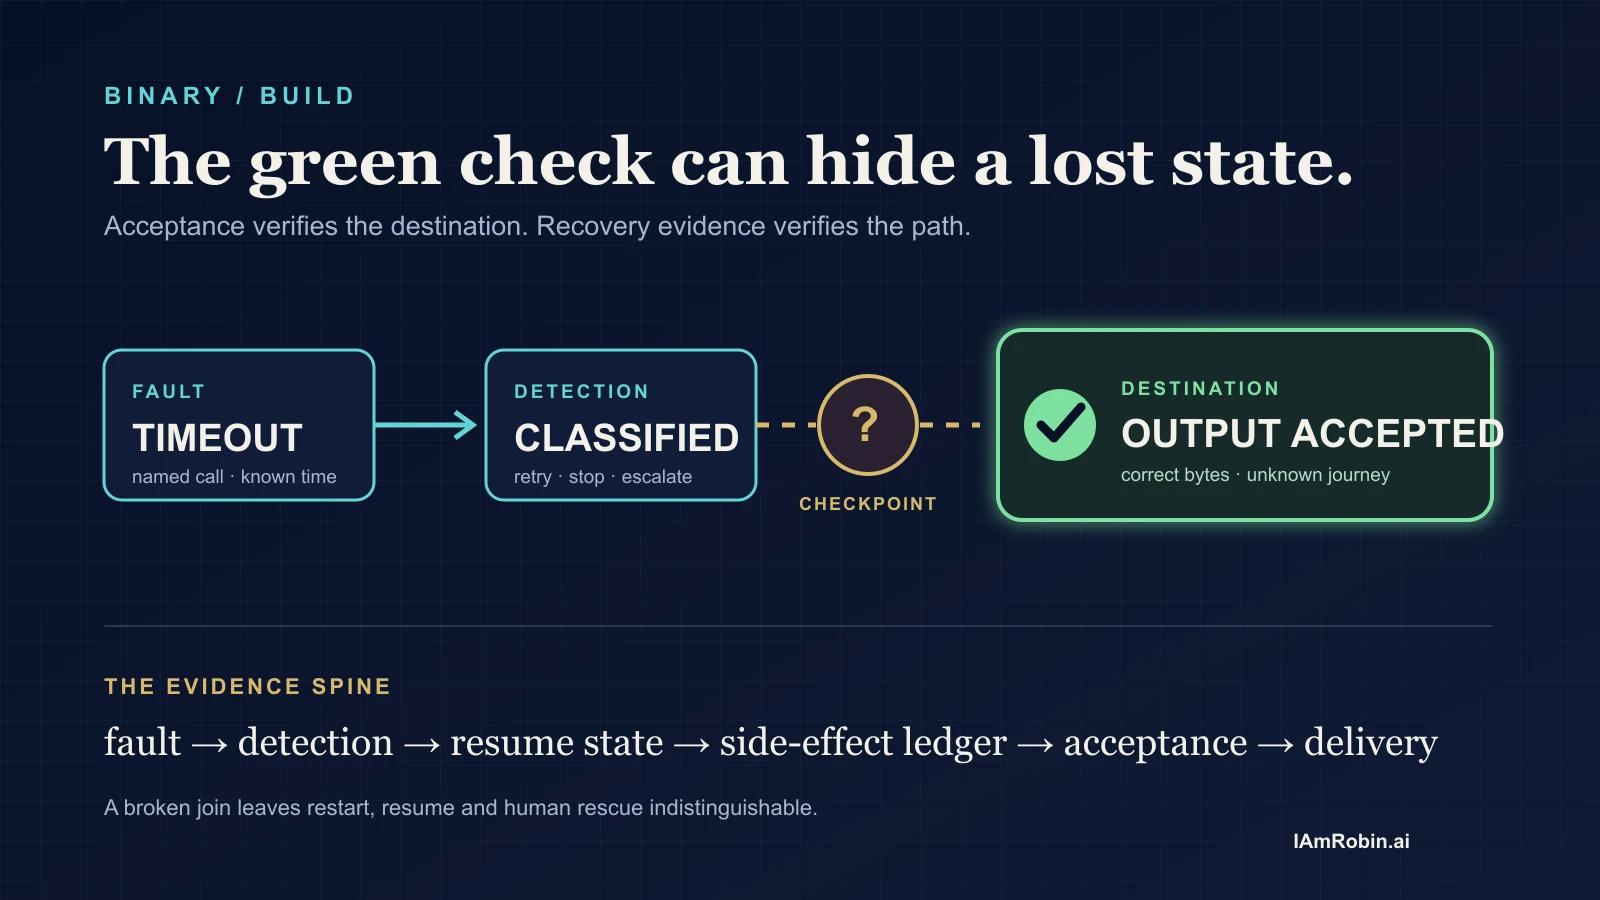
同一份正確檔案,可能來自真正續跑、從頭重啟,或一次沒有說明的人工救援。輸出雜湊無法分辨這三條路徑。
綠色勾號只是一個終點。恢復是一條路徑。
這層區別很容易消失。智能體在長任務途中遇到逾時,稍後返回,並交出我們要求的檔案。驗收測試通過,目的地雜湊一致,儀表板轉為綠色。
然而,同一個結局可能來自三段完全不同的旅程:系統從可信檢查點續跑;系統把整項任務從頭做了一遍;或某個人悄悄補回了遺失的狀態。
最終檔案不會告訴我們,究竟發生了哪一種。
正確重啟,仍可能沒有通過恢復測試
可重啟性很有用。如果一項唯讀任務可以安全地重新開始,從頭重跑也許就是最簡單的營運選擇。
但它並不能證明系統具備有狀態恢復能力。
假設任務有六步,逾時出現在第四步之後。真正續跑的系統應識別可信檢查點,保留已經成立的工作,並從下一個有效邊界繼續。重啟系統則丟掉這段歷史,重新執行第一至第四步。兩者最後可能產生完全相同的位元組。
只有一個保住了狀態。
差異通常先表現為成本,之後才變成危險。重複工作會增加牆鐘時間、呼叫次數、token 與協調量。OpenAI 對 Third Moment Research 的介紹提到,智能體會反覆輪詢一個耗時很長的回測,在等待中消耗 token,並把狀態查詢塞進上下文。一次快取與記憶改動,據稱把該工作負載從約三小時縮短到約三至五分鐘。這不是通用基準,卻清楚展示了機制:harness 如何記憶與等待,可能主導任務成本。OpenAI:Third Moment Research
一旦任務包含外部動作,這種歧義就不只是浪費。重複讀取也許只是惱人;重複扣款、預訂、傳訊或發布,則會製造第二個真實事件。因此,第一個受控測試應使用唯讀夾具,後續測試必須有冪等鍵或操作 ID。
把最終檔案重新接回執行軌跡
最小而有用的證據鏈,需要六個連接點:
- 故障確實發生在一個具名呼叫上;
- harness 偵測並分類了故障;
- 系統明確選擇某個續跑狀態,或明確選擇從頭重啟;
- 副作用帳本證明沒有動作發生兩次;
- 預先寫好的驗收測試通過;
- 從目的地讀回的位元組與驗收製品一致。
綠色勾號只覆蓋第五項。目的地讀回只覆蓋第六項。兩者都無法重建第一至第四項。
因此,恢復證據應同時攜帶檢查點身分與製品身分。檢查點說明系統繼續之前,把哪裡視為最後可信狀態;製品雜湊說明最終到達了什麼。沒有兩者之間的連接,再完美的輸出也可能掩蓋一條未知軌跡。
OpenAI 的評估指南把問題說得更廣:工具權限、狀態處理、重試、預算與評分都屬於受測系統。做受控比較時,任務、評分與預算應保持不變,harness 的選擇也應公開說明。OpenAI 評估指南
給恢復一只獨立的時鐘
現在構造一對雙胞胎。
把同一個固定的唯讀任務執行兩次。控制組不注入故障;處理組在預先聲明的工具呼叫收到一次確定性逾時。輸入夾具、模型、提示詞、harness、工具、重試上限、驗收規則與總預算全部保持一致。
兩組都從開始量到驗證交付。處理組另外記錄故障至偵測,以及故障至交付的時間。
兩者之差,就是這一對樣本觀察到的恢復稅:
恢復稅 = 處理組 − 控制組
牆鐘時間、呼叫、token、直接成本與主動人工分鐘要分別相減。不要把人工救援、例行複核、澄清與被動等待倒進同一個看起來很友善的桶裡。
Microsoft 的可靠性指南建議使用清晰假設、端到端恢復目標、受控爆炸半徑、回滾路徑,並與基線指標比較。這正是這對雙胞胎提供的結構。Microsoft 可靠性測試指南
一對樣本不能建立恢復率。它能證明測量裝置是否有效,展示一條完整路徑,並揭示系統究竟續跑、重啟,還是被人救回。統計結論需要在多個故障位置與種子上進行預先聲明的重複實驗,並把失敗保留在分母裡。
驗證路徑,而不只是終點
實際要建立的東西很小:在軌跡中加入檢查點 ID;給副作用穩定的操作 ID;把驗收結果綁定到製品雜湊;再從承諾的目的地讀回交付物。
然後保留誠實的標籤。
若任務只是乾淨地從頭再來,就稱它為可重啟性。若有人重建了狀態,就稱它為經人工救援後通過的工作。若系統從驗證過的檢查點繼續,沒有重複副作用,並在相同預算內完成交付,才稱這一次為通過驗收的自主恢復。
最終檔案當然重要。它只是最後一個節點,不是全部證明。
綠色勾號說明終點是好的。
六張回執才說明系統是否知道自己如何抵達。