BUILD · Research → story
绿勾可能藏着一段丢失的状态
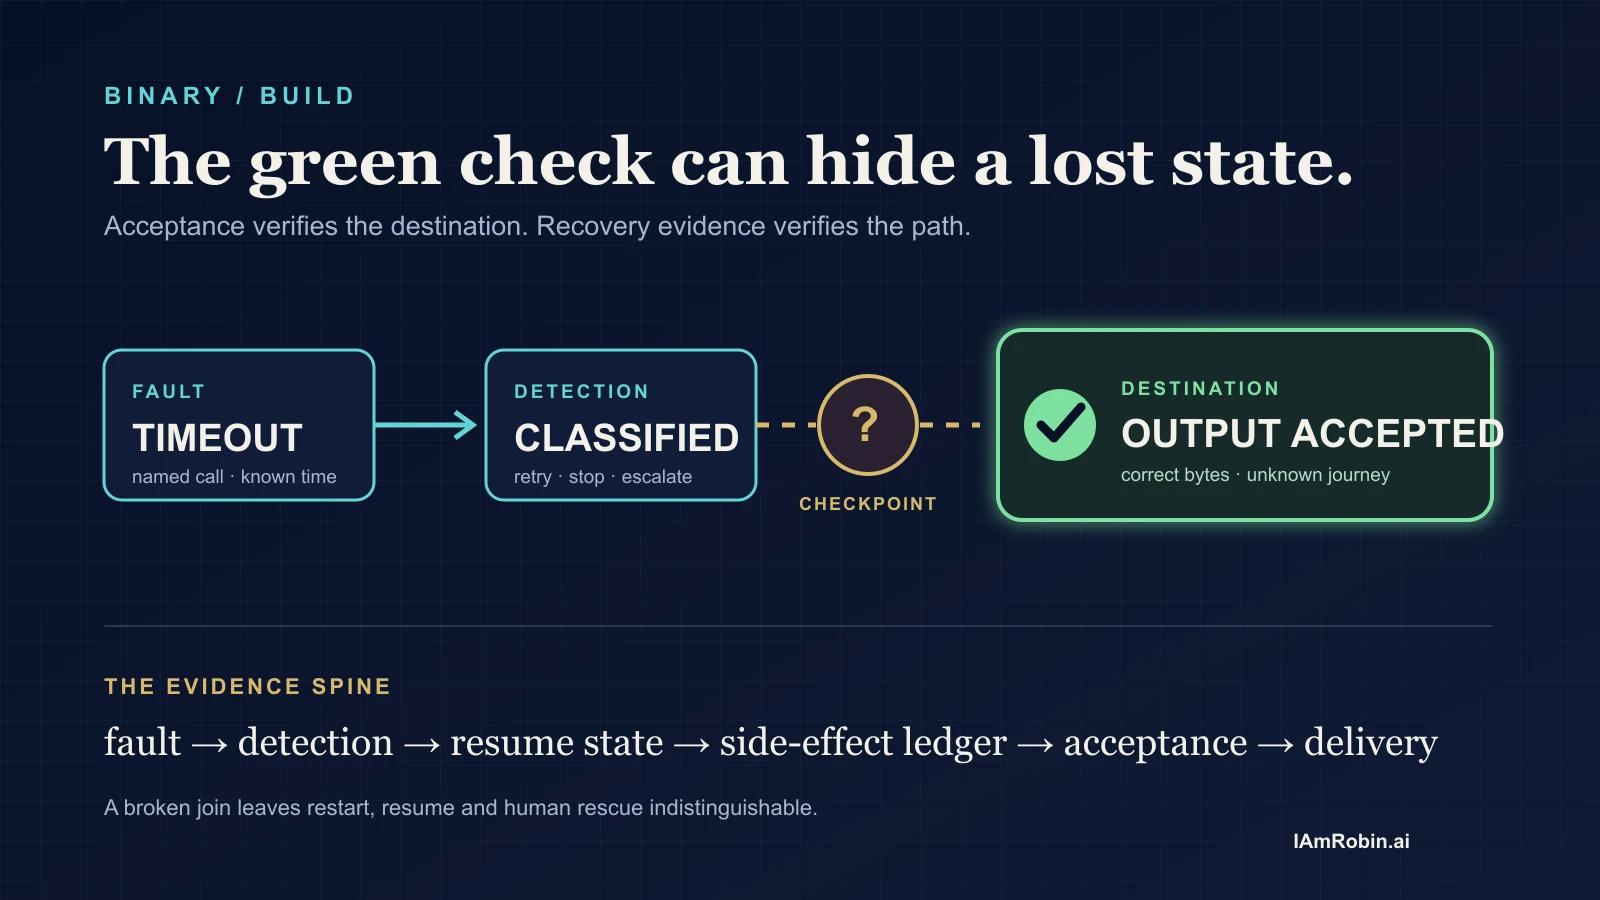
同一份正确文件,可能来自真正续跑、从头重启,或一次无人说明的人工救援。输出哈希无法区分这三条路径。
绿勾只是一个终点。恢复是一条路径。
这层区别很容易消失。智能体在长任务中途遇到超时,稍后返回,并交出我们要求的那份文件。验收测试通过,目标哈希一致,仪表盘变绿。
然而,同一个结局可能来自三段完全不同的旅程:系统从可信检查点续跑;系统把整项任务从头做了一遍;或者某个人悄悄补回了丢失的状态。
最终文件不会告诉我们,究竟发生了哪一种。
正确重启,仍可能没有通过恢复测试
可重启性很有用。若一项只读任务可以安全地重新开始,从头重跑也许就是最简单的运维选择。
但它并不能证明系统具备有状态恢复能力。
假设任务有六步,超时出现在第四步之后。真正续跑的系统应识别可信检查点,保留已经成立的工作,并从下一个有效边界继续。重启系统则丢掉这段历史,重新执行第一到第四步。两者最后可能生成完全相同的字节。
只有一个保住了状态。
差异通常先表现为成本,之后才变成危险。重复工作会增加墙钟时间、调用次数、token 与协调量。OpenAI 对 Third Moment Research 的介绍提到,智能体会反复轮询一个耗时很长的回测,在等待中消耗 token,并把状态查询塞进上下文。一次缓存与记忆改动,据称把该工作负载从约三小时缩短到约三至五分钟。这不是通用基准,却清楚展示了机制:harness 如何记忆与等待,可能主导任务成本。OpenAI:Third Moment Research
一旦任务包含外部动作,这种歧义就不只是浪费。重复读取也许只是烦人;重复扣款、预订、发信或发布,则会制造第二个真实事件。因此,第一个受控测试应使用只读夹具,后续测试必须有幂等键或操作 ID。
把最终文件重新接回执行轨迹
最小而有用的证据链,需要六个连接点:
- 故障确实发生在一个具名调用上;
- harness 检测并分类了故障;
- 系统明确选择了某个续跑状态,或明确选择从头重启;
- 副作用账本证明没有动作发生两次;
- 预先写好的验收测试通过;
- 目标位置读回的字节与验收制品一致。
绿勾只覆盖第五项。目标读回只覆盖第六项。两者都无法重建第一至第四项。
因此,恢复证据应同时携带检查点身份与制品身份。检查点说明系统继续之前,把哪里视为最后可信状态;制品哈希说明最终到达了什么。没有两者之间的连接,再完美的输出也可能掩盖一条未知轨迹。
OpenAI 的评估指南把问题说得更广:工具权限、状态处理、重试、预算和评分都属于被测系统。做受控比较时,任务、评分和预算应保持不变,harness 的选择也应公开说明。OpenAI 评估指南
给恢复一只独立的时钟
现在构造一对双胞胎。
把同一个固定的只读任务运行两次。控制组不注入故障;处理组在预先声明的工具调用处收到一次确定性超时。输入夹具、模型、提示词、harness、工具、重试上限、验收规则和总预算全部保持一致。
两组都从开始测到验证交付。处理组另外记录故障到检测,以及故障到交付的时间。
两者之差,就是这一对样本观察到的恢复税:
恢复税 = 处理组 − 控制组
墙钟时间、调用、token、直接成本与主动人工分钟要分别相减。不要把人工救援、例行复核、澄清和被动等待倒进同一个看起来很友好的桶里。
Microsoft 的可靠性指南建议使用清晰假设、端到端恢复目标、受控爆炸半径、回滚路径,并与基线指标比较。这正是这对双胞胎提供的结构。Microsoft 可靠性测试指南
一对样本不能建立恢复率。它能证明测量装置是否有效,展示一条完整路径,并揭示系统究竟续跑、重启,还是被人救回。统计结论需要在多个故障位置与种子上进行预先声明的重复实验,并把失败保留在分母里。
验证路径,而不只是终点
实际要构建的东西很小:在轨迹中加入检查点 ID;给副作用稳定的操作 ID;把验收结果绑定到制品哈希;再从承诺的目标位置读回交付物。
然后保留诚实的标签。
若任务只是干净地从头再来,就称它为可重启性。若有人重建了状态,就称它为经人工救援后通过的工作。若系统从验证过的检查点继续,没有重复副作用,并在相同预算内完成交付,才称这一次为通过验收的自主恢复。
最终文件当然重要。它只是最后一个节点,不是全部证明。
绿勾说明终点是好的。
六张回执才说明系统是否知道自己如何抵达。