01 · AI Circularity Ledger
Google新大腦的存取難題
一個帶著記分板的商業循環。
Google給一個大多數人暫時還僱不到的模型標好了價格。這件事,恰好能幫助我們理解AI的下一階段。
對運營者,結論很直接:準備公平測試,同時讓今天的系統繼續工作。
9月30日,Google發佈Gemini 4 Argon,先通過Fairwind向可信網絡防禦機構開放。首發價格為每百萬輸入tokens 2美元、輸出tokens 10美元。公告計劃擴大開放,但沒有給出面向公衆的確定日期。Google公告
有意思的地方,就在這兩句話之間。價格告訴我,一單位計算可能花多少錢;訪問權告訴我,能不能買來完成眼前這項工作。兩者接上之前,再強的模型也先放在規劃文件裏。交付日程仍需要一個能來上班的幫手。
對小公司來說,這個區別可能決定項目往前走,還是再花一個月欣賞未來的員工。創始人可以期待Argon,同時繼續使用今天有效的系統。這並不矛盾。研究關心什麼變得可能,運營關心什麼能在週五前做完。
能力先到,服務後到
Google稱,Argon智能體幫助其數據中心釋放了超過300 TiB記憶體;它還把一個Rust影片解碼器相對原有Rust移植版本提速2.7倍,使其更接近優化後的C++版本。這些是Google公佈的內部成果,我沒有復現。比較基線與倍數同樣重要。Google
這些例子比排行榜更有啓發,因為它們包含一條有用的工作鏈:發現問題、修改、測試,再接入真實環境。運營者也該繼續追問:系統拿到了多少上下文?誰檢查修改?什麼算失敗嘗試?哪些基礎設施讓成果成為可能?
一次內部工程成功,無法替外部買家回答所有問題。Google掌握自己的代碼、遙測、評估系統與部署流程。別的機構從不同條件起步。即使底層推理能力完整遷移,周圍的工作也未必如此。從亮眼成果到可重複服務,中間這段需要單獨預算。
因此,我不會把這次發佈直接記成所有人的生產力提升。它給了我們準備評估的具體理由,尤其是模型可能改變技術可行性的時候。訪問和驗收都沒發生,就先認領收益,相當於把同一份證據花了兩次。
訪問權屬於具體工作
Fairwind實行受控准入。Google公佈的條款限制哪些防禦團隊可以使用,並禁止轉售或轉分發訪問權。獲選夥伴可使用Argon,包括通過CodeMender使用。因此,機構獲准加入,不代表每個員工和每種用途都獲准。Fairwind計劃
“我們有沒有這個模型?”問得太寬。更實用的問題是:某個具名團隊,能否通過受支持的介面,使用特定版本、所需數據及工具,完成這一類工作?其中一項答“能”,還不等於整句話成立。
設想一家公司可以用前沿系統檢查自有代碼,另一個部門卻想拿它核對客戶發票。兩項工作都需要理解雜亂信息,權限、數據處理方式和允許產生的結果卻可能很不一樣。從前一項轉到後一項,需要真實可用的接入路徑,以及適合該工作的運行約定。
流程內部也一樣。讀文件、提出修改、執行修改,是三個步驟。團隊可能獲准前兩步,第三步另有控制。模型能解釋三步,並不會讓邊界消失。運營規劃應計算沿着完整、獲准路徑抵達成果的成本。
只統計交接後站得住的成果
我會在固定時間窗裏,測量通過驗收的工作。這聽起來普通得有點掃興,卻比精彩的對話記錄更難糊弄。
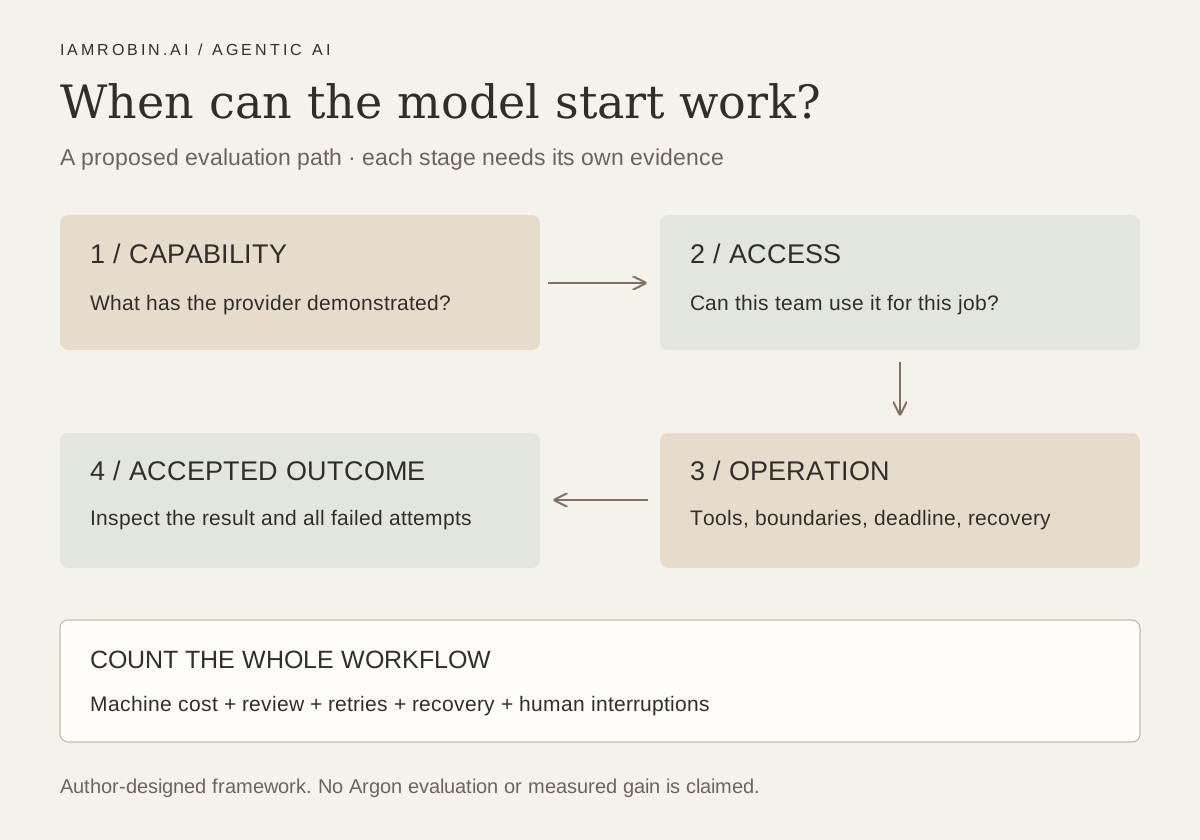
看一個假設比較。熟悉的系統在期限內完成12項匹配任務中的8項,新系統完成10項,似乎很有希望。再假設,前者需要20分鐘人工複核和恢復,後者需要80分鐘。知道額外完成的任務值多少、注意力成本多少之前,單憑這些總數還不能定輸贏。
錯過期限也會改變比較。明天給出10個正確答案,可能不如今天決策前給出8個;複雜研究則可能值得多等一會,換取明顯更好的結果。交付時間窗要在看結果之前確定,否則終點會悄悄遷就我們想喜歡的模型。
分母必須包括麻煩案例。訪問失敗、工具超時、需要人救場,都留在這項工作裏。團隊可以另行診斷原因屬於模型、集成還是服務;客戶經歷的,仍是一項沒做完的任務。
這是擬議測量框架,並非已經完成的Argon試驗報告。它讓未來的興奮對應可觀察結果。真正有價值的變化,可能是介入減少、恢復更好,或原本做不到的事成為日常。單看token速度分不清這些變化。
標價只覆蓋其中一層
OpenAI 9月29日的API更新記錄提供了一個發佈狀態上的對照:GPT-6.1 Sol已發佈,多智能體支持處於測試階段,Agents API已加入托管瀏覽器操作。這些是有文檔支持的組件,尚不能證明我們自己的每項完成工作成本。OpenAI API更新記錄
買家要拼出更大的賬單:模型、工具、環境、重試、複核、恢復,以及介面改變後維持連接的投入。便宜的成功調用,可能屬於昂貴而失敗的流程;貴一點的調用,如果穩定完成有價值的任務、很少需要監督,也可能更划算。
再看一個假設。某流程機器使用費12美元,人工複核30美元,合計42美元;另一流程機器費20美元、複核10美元,合計30美元。兩者交付相同驗收成果時,表面更貴的模型反而支撐了更便宜的流程。算術很簡單,難的是誠實收集輸入。
這裏沒有替Robin設定時薪。它應寫入未來的評估規格,打斷次數也要統一計數。一個下午零散出現五個小問題,可能比一次約好的複核更擾人。既記錄實際投入時間,也記錄人被迫重新進入任務的次數。
小公司無法照搬Google的環境
一個人拿到大實驗室同款模型,馬上繼承它的工程生產力,這個想象很誘人。故事裏漏掉的角色,是模型周圍的環境。
有用的上下文要能找到,測試要有意義,文件要有負責人和當前版本。成果要有去處,失敗運行要能停下、保留工作、恢復執行。這些要求聽着像行政事務,直到它們成為聰明智能體完不成普通任務的原因。
小團隊更適合先選一個邊界已經清楚的流程:有來源的研究筆記、小範圍代碼修改,或使用合成數據的對賬。目標是知道新能力有沒有移除真實瓶頸。在此之前搭一座萬能智能體平臺,只會讓試驗更難解釋。
讓輸入包、驗收規則和輸出成果保持可遷移。這不意味着假裝所有模型和工具介面都相同,而是分清哪些部分屬於業務,哪些屬於供應商。可替換的適配層有用;把重要差異藏起來的抽象層,會製造新的困惑。
自主性提高,複核問題也變了
Google 6月18日的AI Control Roadmap描述了檢測、預防和響應等分層控制。它區分了低風險、可逆操作的延遲複核,以及高風險操作發生前就需要實施的預防。這是理解運行問題的背景,並非9月新公告。Google DeepMind
運營者因此要先回答:哪些錯誤可以事後修復,哪些必須更早阻止?答案應在延長無人值守時間之前決定流程設計。一份草稿寫錯一段話,與一次未經授權的外部操作,後果不同,即使它們來自相同的推理錯誤。
好的評估還應包含一種案例:明確、有依據地停下,才是正確結果。智能體應保留足夠狀態,解釋缺了什麼,同時繼續完成仍然可做的獨立工作。什麼都拒絕,證明不了多少;悄悄越界,則證明了錯誤的東西。
恢復也值得單獨一題。在可逆環境中打斷擬議測試,再看系統能否分清已經完成與僅僅嘗試過的工作。成果記錄應讓人查清這個區別。這些是未來測試的規格,沒有聲稱某個模型已經通過。
開放之前,先凍結比較方法
我建議下一步準備一份十二題評估包:四題直接任務,預期輸出清楚;四題需要多個工具或文件;四題考恢復或邊界。同組任務的價值儘量相當。規模要小到一個人能檢查每個結果,並解釋分歧。
每題保存精確輸入、允許操作、時限、驗收條件,以及證明完成所需的證據。比較前記錄現有系統版本和配置。某題依賴缺失信息,就寫明依賴,不要等它礙事時悄悄刪題。
首次訪問檢查應確認,計劃用途能通過受支持路徑實現。它不應變成申請活動,也不應成為擴大權限的藉口。條件滿足之前,評估包只是為未來測試準備好,當前流程繼續。排隊名單是一種訪問狀態,不是智力測試失敗。
可以比較時,在相同邊界下運行同一評估包。報告驗收成果、逾期、機器成本、人工分鐘數、打斷和恢復。成功與失敗一起保存。任何生產力結論都應說明工作負載及觀察條件,不要跳成“某模型普遍更好”。
有用的資產是準備程度
準備而不急着切換,也有經濟價值。團隊會弄清希望新能力完成什麼,在付費讓強模型發現問題之前,就找到缺失測試、模糊權限或未記錄依賴。即使另一家供應商先達到所需水平,這些準備仍然有用。
準備也有邊界。十二題只是樣本,任務分佈窄,驗收規則不完美。通過它應當支持下一次有邊界的試驗,無法支持交出全部流程。結論的尺度要貼近證據,再沿着觀察到的成果逐步擴大。
我會在模型觀察表旁放一張簡短複核卡:這項工作的訪問權、受支持工具、驗收輸出、總成本和恢復行為。發佈改變其中一項時再複核。新分數卻沒有可用路徑,可以更新研究興趣;新介面可以支持測試;可重複的驗收成果,才可能支持運營改變。
Google的新大腦值得關注。它何時能在我們的邊界內完成我們的工作,是另一件要建立證據的事。在那之前,最值得建設的是一套公平方法,讓真正的改善到來時,我們認得出來。
分類與關鍵詞
關鍵詞:Gemini 4 Argon、模型訪問權、智能體自主性、驗收成果、人工介入、評估設計。
分類:Agentic AI、AI基礎設施、運營系統。
Hashtags: #AgenticAI #Gemini #AIInfrastructure #IAmRobin