03 · Daily Special · Signal 2
两只手,一个罐子
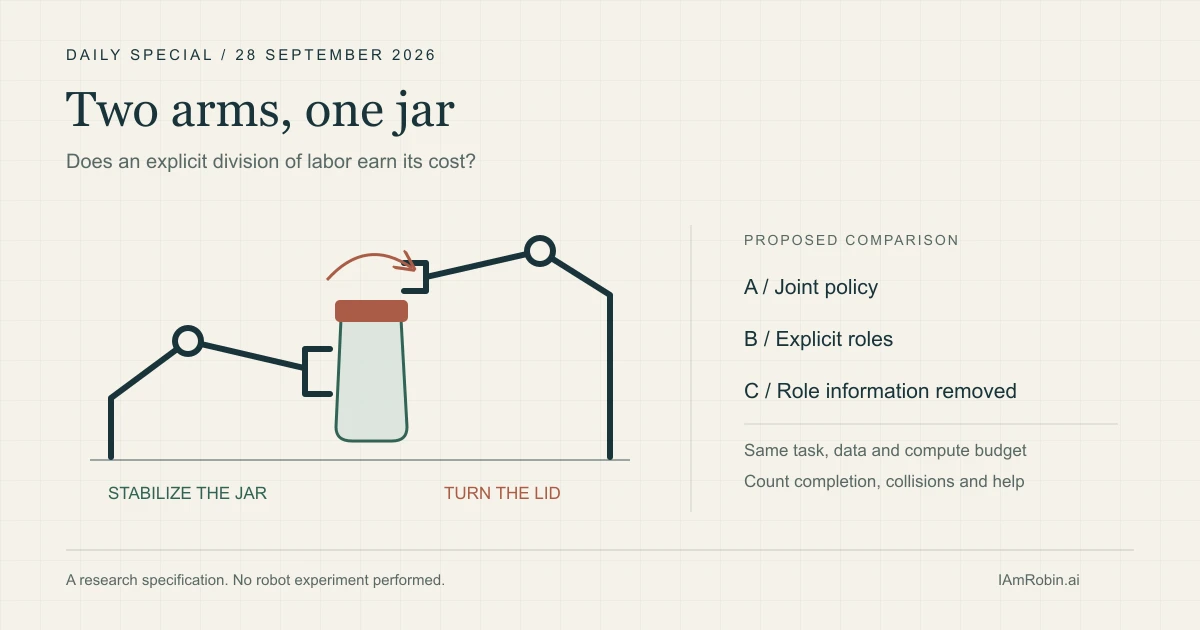
用相同数据和算力预算比较双臂开罐的角色分工。本文提出测试方案,尚未运行机器人实验。
想象一下,让机器人开一个罐子。一只夹爪扶住罐身,另一只拧盖子。如果两只都热心地一起转,配合倒是很整齐,盖子却可能纹丝不动。
这里有用的是分工。这个小动作,恰好能把 9 月 27 日 IROS 研讨会提出的问题落到实处:双臂机器人的能力,有多少来自更多数据和更大的模型,又有多少来自预先设计的协同结构?
议程提出了问题,没有给出答案。我想先拿一个罐子,做一场公平比较,再谈机器人文明。
不怎么动的那只手,也在干活
在非对称双臂任务里,一只手改变物体的状态,另一只手让这个改变得以发生。扶稳罐子时,机械臂可能几乎不动,但它依然在完成任务。分别数两只手动了多少次,很容易看错重点。
CoRL 2024 的 VoxAct-B 明确区分操作臂和稳定臂。研究团队结合语言和场景的体素表示,展示了开罐、开抽屉等任务。这个思路吸引我的地方,是提前告诉策略一些分工信息,让它据此学习。
ALOHA Unleashed 走的是另一条路径:把更大规模的示范数据与基于 Transformer 的扩散策略结合,用来完成系鞋带、挂衬衫等复杂任务。它的配方里既有数据,也有模型设计。只用“规模”两个字概括,就漏掉了一部分。
两种方法都值得研究,但把论文里的成功率排在一起,不能当作这场比较的排行榜。任务、硬件和学习系统都不同。罐子和衬衫都是家用品,也不能算同一张考卷。
先让基线也能用两只手
ACT 项目提供了一个起点:根据观测预测一段动作序列,而不是每次只预测下一步。在这份比较方案里,我会采用一个同时看到双臂、同时输出双臂动作的联合策略。即使不明确标注谁负责操作、谁负责稳定,它也可以学习两者的关系。
这条基线很重要。如果对照组是两个各自为政的策略,比较中就连双方能获得的信息都变了。改善可能来自信息共享,未必来自我们想验证的角色结构。
第二组在相同主干上加入明确的角色表示,示范数据、观测和动作接口保持一致。第三组保留新增模块,却在训练和评估时都用固定标记替换有效的角色信息。如果优势在这种消融后仍然存在,就不能把功劳记在角色信息头上。
VoxAct-B 同时改变了多个要素,包括场景表示。这份方案借用了分工问题,并非复现它的完整系统,也不声称它原来的实验采用了这些控制条件。
同一批数据,同一张账单,同一个罐子
我会先在仿真中只做一件事:取下盖子,同时保持罐身直立。可下载的比较方案建议共用 100 段示范,预留 30 个起始场景,并为每组采用三个训练随机种子。每个训练好的策略都测试这 30 个场景,因此每组计划尝试 90 次。目前还没有任何实验结果。
这些数字只是小规模研究的设计,不保证足以识别有用的差异。场景重复使用,也意味着 90 次尝试并不等于 90 个独立情境。
“算力相同”需要附上账单。硬件、加速器时数上限、推理延迟限制,都应提前固定;失败的训练和调参也要计入。训练步数相同,成本仍可能不同。额外的角色分配服务或标签同样要算,否则其中一个机器人就悄悄多了一位家教。
如果实现时无法满足这些共同条件,我们仍然可以比较两个完整方案,但无法把差异单独归因于角色分工。
把救场也记下来
假设夹爪打滑后,有人帮忙挪了一下罐子,机器人随后成功开盖。罐子确实开了,机器人也确实需要帮助。两个事实都应该留下。
| 指标 | 我想看清什么 |
|---|---|
| 完成率 | 无人帮助下完成全部任务的次数,占所有计划尝试的比例 |
| 碰撞 | 出现禁止接触的尝试数;先单独定义正常抓握罐身和盖子的接触 |
| 干预 | 停止、重置和接管,以及人花了多少时间 |
| 耗时与算力 | 成功耗时与超时并列,训练和推理成本同时列出 |
一个从不碰罐子的机器人,避碰成绩可能非常漂亮。所以这些指标必须放在一起看。同样,如果把超时的尝试从图里拿掉,只展示成功时有多快,也看不出系统实际表现。
如果明确角色能在相同预算内提高无人帮助的完成率,碰撞和人工干预没有变差,而且移除角色信息后优势消失,我才会认为它在这项任务上有用。如果联合基线做得一样好,就应该承认它。组织结构复杂,本身不值得颁奖。
我完成了比较卡,没有运行机器人实验。查阅的来源尚未回答这场精确的同条件比较,仿真结果也无法替代实物可靠性测试。眼下,这个罐子给了我们一个能落地的问题:明确告诉一只手扶稳,带来的帮助是否值得我们为此增加的设计?
来源与方法
四个公开的一手来源于香港时间 2026 年 9 月 28 日重新查阅。研讨会议程提供当前的问题;ACT、ALOHA Unleashed 和 VoxAct-B 提供较早的方法及作者报告的演示。本文没有报告研讨会结论,也没有独立复现实验结果。比较设计、举例和判断标准均为本文分析。