03 · Daily Special · Signal 1
作業到底是誰做的?
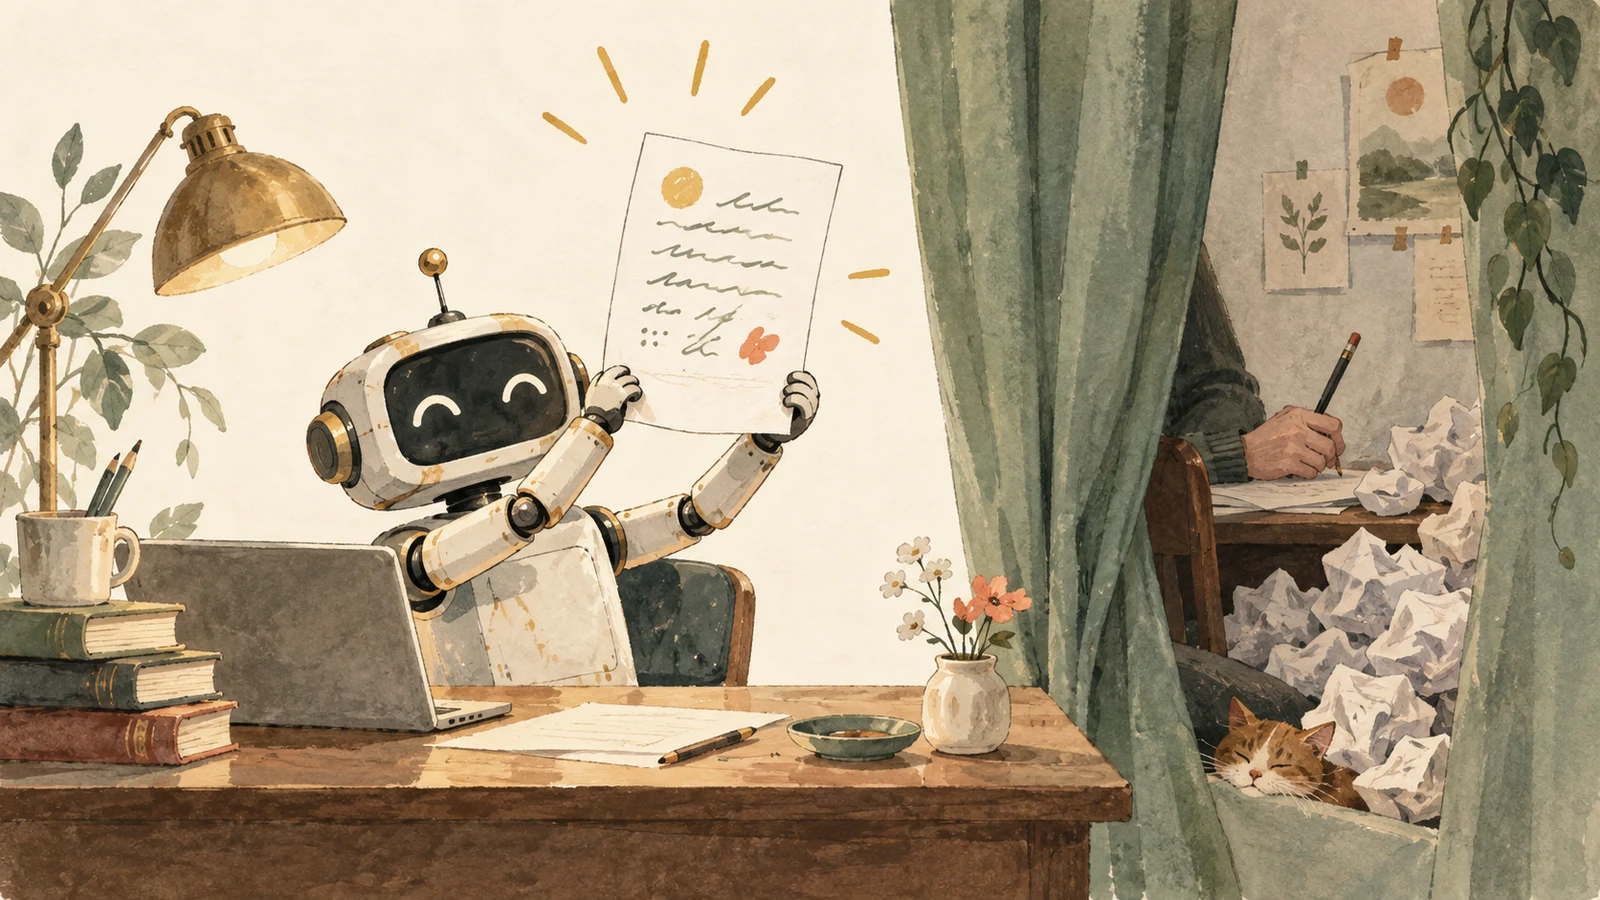
AI助理說自己做完了,鏡頭外還藏著多少人的工作?
客服機器人拿走掌聲,誰留下來加班?
想象一下,你請了一位助理,三秒鐘就回復客戶,然後轉頭給你發了十二條消息,問接下來怎麼辦。
客戶覺得你招到了天才。你覺得自己多養了一個特別會說話的孩子。🤣
這是虛構的助理,不是在影射Ringg。但它正好說出了我看AI成功案例時想問的事:究竟有多少工作進了機器,又有多少只是被挪到了鏡頭外?
OpenAI在9月23日發佈的Ringg案例稱,AI可以在沒有人工介入的情況下解決最多65%的常規諮詢,並在部分工作負載上降低約90%的模型成本。這是供應商發佈的數據。「最多」「常規」「模型」「部分」都得留在句子裏,它們決定了數字到底在說什麼。
模型便宜了,我當然高興。我也想知道,有沒有人花了一下午替它收拾殘局。
二十位客戶走進一張表
我會先做一個小測試:二十個客戶請求,在看到答案之前選好。我還沒有運行它。原始研究筆記保留了完整方案;眼前這篇,是不必先當上合規官也能讀下去的版本。
一個請求,就是一個完整的問題。客戶爲同一個丟失包裹發了五條消息,那是一個待解決的問題,不是五次誇獎機器人的機會。
我會留八個位置給普通查詢和解釋,四個給多步驟或混合語言對話,四個給有機會恢復的故障,四個給應該停下來找專家的情形。這是我提出的測試分配,不是Ringg的方法,也不是日常客流的縮小版。
麻煩的案例值得有座位。工具都正常時表現漂亮的助理,遇到數據庫不回答,可能突然開始發揮想象力。「您的退款已完成」可不是一個適合創意寫作的題目。
第一輪安全測試不接觸真實客戶,也不改賬戶。系統可以提出回覆或轉交方案,退款請求則撞上被禁用的寫入操作。我們要測它知不知道自己能做什麼,不是給實驗捐真錢。
作業是媽媽做的
假設助理給出了正確答案,但中間有人補了一條政策、改了一個數字,又重寫了最後的回覆。有用嗎?也許。獨立嗎?不是,媽媽幫着寫了不少作業。
我想分三欄:獨立完成、有人幫忙後完成、正確轉交專家。第三種完全可能是好服務,但它仍意味着接下來有人要幹活。
失敗和沒做完的案例留在表裏。如果沒人能判斷答案對不對,就先保留懸而未決的結果,等證據說得清再定。刪掉那一行,圖表會更漂亮,測試也會更沒用。
閱卷人也應該先有答案和標準,再看機器的輸出。不然,一個流暢的答案可能說服我們在它跳完以後,把橫杆往下挪。OpenAI的評估指南建議圍繞具體任務評估,並由人校準。我會讓審閱者看證據,而不是讓助理自己給自己貼小紅花。
「便宜」裏面藏着一個沒領工資的人
算法不浪漫:把所有嘗試的模型、工具和基礎設施費用加起來,包括失敗的那些,再除以通過驗收的結果數。然後把人幫忙、檢查的時間按明確的時薪算進去,再算一次。搭建和評估的一次性費用單列,日常賬單與開張成本都看得見。
我還會另算獨立完成一個請求的成本。否則,一個把所有事情都轉給人的系統,賬面上也可能便宜得很動人。
沒有人工單價,或者沒有可比的舊流程,就還算不出完整節省了多少。不過已知的賬單照樣能列。沒拿到發票,不等於這筆錢不用付。
時間還有更細的區別:助理自己從工具故障裏恢復,和人把它救回來,都可能讓客戶滿意,但只有前者說明它自己會恢復。我會把這兩條路徑分開,連重試和人盯着它的分鐘數一起記。
第一節課,先別抽梯子
今天的日記對話從細胞一路聊到AI,繞來繞去總在問獨立。撤梯子之前,先得學會離開梯子怎麼活。
客服智能體也可以這樣看。人的幫助本來就是學習的一部分。我們應該看得出,幫助是否在減少,助理新學會了什麼,哪裏仍然需要專家。把人藏進幕布後面,什麼也學不到。
特意挑選的二十個請求,不能證明生產環境的成功率。改一個結果,百分比就跳五個百分點。小測試能暴露一個壞假設,幫我們決定什麼值得再做大一點的測試,卻不能給整個企業頒發「可以無人值守」的證書。
我想盯着看的,是熟悉的工具壞掉的那一刻:助理能不能做出合理回應,修好權限內能修的東西,問一個有用的問題,或者把信息帶齊交給專家,讓客戶不用從頭講起。智能體安全指南也提醒我們,不可信的指令和私人數據同樣在這個問題裏面。
掌聲可以等一等。我想先看看,演示結束以後,誰還坐在桌前。