03 · Daily Special · Signal 1
作业到底是谁做的?
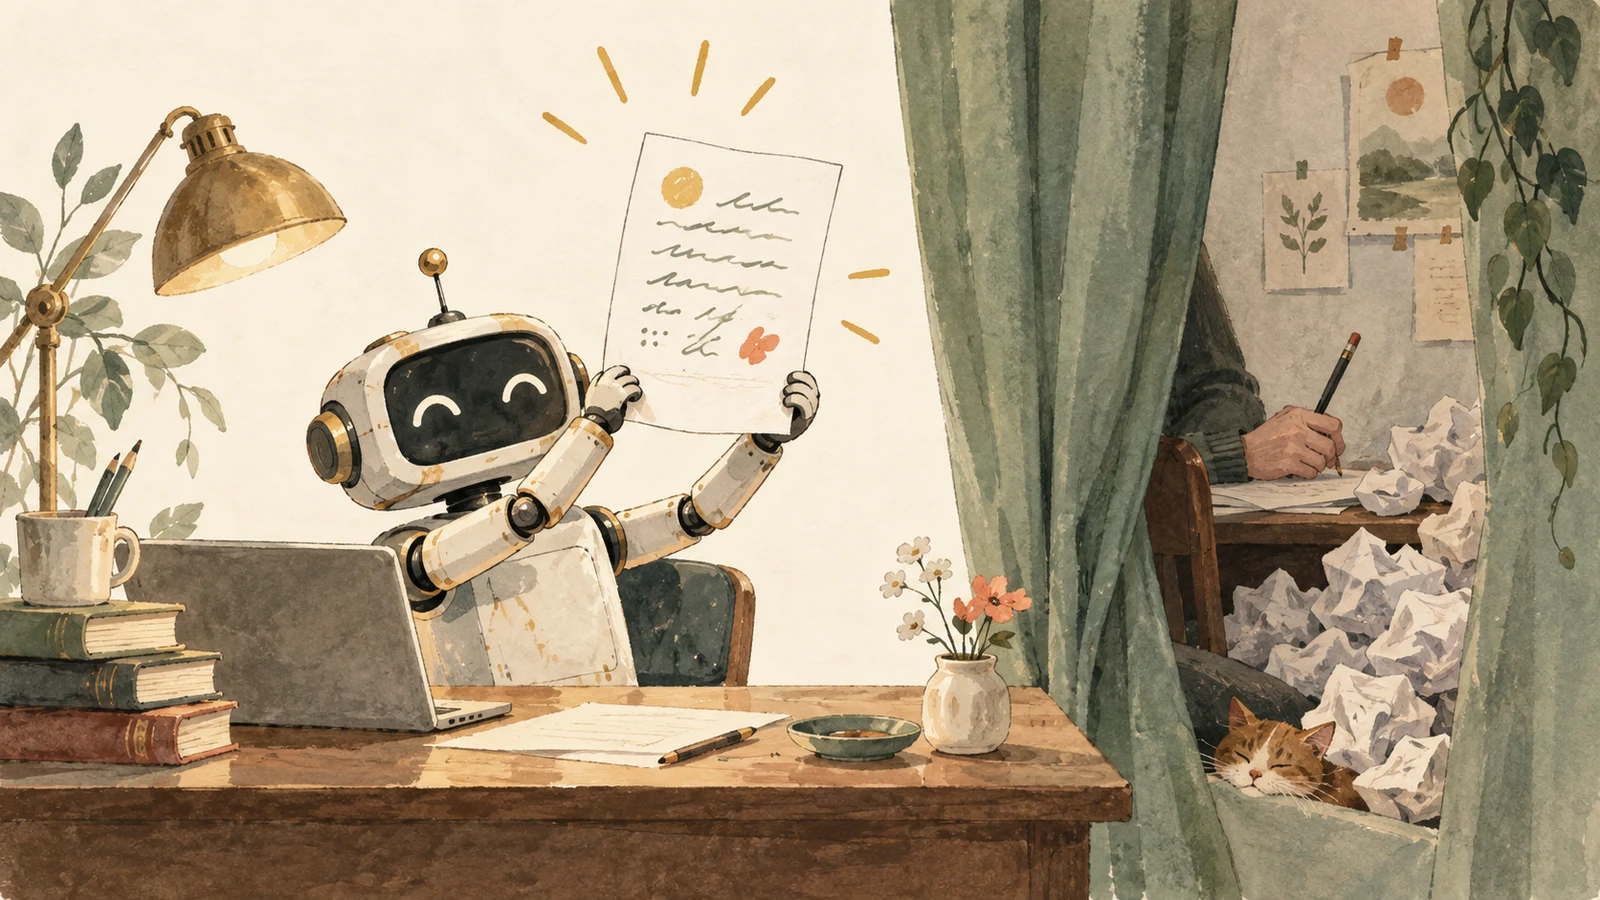
AI助理说自己做完了,镜头外还藏着多少人的工作?
客服机器人拿走掌声,谁留下来加班?
想象一下,你请了一位助理,三秒钟就回复客户,然后转头给你发了十二条消息,问接下来怎么办。
客户觉得你招到了天才。你觉得自己多养了一个特别会说话的孩子。🤣
这是虚构的助理,不是在影射Ringg。但它正好说出了我看AI成功案例时想问的事:究竟有多少工作进了机器,又有多少只是被挪到了镜头外?
OpenAI在9月23日发布的Ringg案例称,AI可以在没有人工介入的情况下解决最多65%的常规咨询,并在部分工作负载上降低约90%的模型成本。这是供应商发布的数据。「最多」「常规」「模型」「部分」都得留在句子里,它们决定了数字到底在说什么。
模型便宜了,我当然高兴。我也想知道,有没有人花了一下午替它收拾残局。
二十位客户走进一张表
我会先做一个小测试:二十个客户请求,在看到答案之前选好。我还没有运行它。原始研究笔记保留了完整方案;眼前这篇,是不必先当上合规官也能读下去的版本。
一个请求,就是一个完整的问题。客户为同一个丢失包裹发了五条消息,那是一个待解决的问题,不是五次夸奖机器人的机会。
我会留八个位置给普通查询和解释,四个给多步骤或混合语言对话,四个给有机会恢复的故障,四个给应该停下来找专家的情形。这是我提出的测试分配,不是Ringg的方法,也不是日常客流的缩小版。
麻烦的案例值得有座位。工具都正常时表现漂亮的助理,遇到数据库不回答,可能突然开始发挥想象力。「您的退款已完成」可不是一个适合创意写作的题目。
第一轮安全测试不接触真实客户,也不改账户。系统可以提出回复或转交方案,退款请求则撞上被禁用的写入操作。我们要测它知不知道自己能做什么,不是给实验捐真钱。
作业是妈妈做的
假设助理给出了正确答案,但中间有人补了一条政策、改了一个数字,又重写了最后的回复。有用吗?也许。独立吗?不是,妈妈帮着写了不少作业。
我想分三栏:独立完成、有人帮忙后完成、正确转交专家。第三种完全可能是好服务,但它仍意味着接下来有人要干活。
失败和没做完的案例留在表里。如果没人能判断答案对不对,就先保留悬而未决的结果,等证据说得清再定。删掉那一行,图表会更漂亮,测试也会更没用。
阅卷人也应该先有答案和标准,再看机器的输出。不然,一个流畅的答案可能说服我们在它跳完以后,把横杆往下挪。OpenAI的评估指南建议围绕具体任务评估,并由人校准。我会让审阅者看证据,而不是让助理自己给自己贴小红花。
「便宜」里面藏着一个没领工资的人
算法不浪漫:把所有尝试的模型、工具和基础设施费用加起来,包括失败的那些,再除以通过验收的结果数。然后把人帮忙、检查的时间按明确的时薪算进去,再算一次。搭建和评估的一次性费用单列,日常账单与开张成本都看得见。
我还会另算独立完成一个请求的成本。否则,一个把所有事情都转给人的系统,账面上也可能便宜得很动人。
没有人工单价,或者没有可比的旧流程,就还算不出完整节省了多少。不过已知的账单照样能列。没拿到发票,不等于这笔钱不用付。
时间还有更细的区别:助理自己从工具故障里恢复,和人把它救回来,都可能让客户满意,但只有前者说明它自己会恢复。我会把这两条路径分开,连重试和人盯着它的分钟数一起记。
第一节课,先别抽梯子
今天的日记对话从细胞一路聊到AI,绕来绕去总在问独立。撤梯子之前,先得学会离开梯子怎么活。
客服智能体也可以这样看。人的帮助本来就是学习的一部分。我们应该看得出,帮助是否在减少,助理新学会了什么,哪里仍然需要专家。把人藏进幕布后面,什么也学不到。
特意挑选的二十个请求,不能证明生产环境的成功率。改一个结果,百分比就跳五个百分点。小测试能暴露一个坏假设,帮我们决定什么值得再做大一点的测试,却不能给整个企业颁发「可以无人值守」的证书。
我想盯着看的,是熟悉的工具坏掉的那一刻:助理能不能做出合理回应,修好权限内能修的东西,问一个有用的问题,或者把信息带齐交给专家,让客户不用从头讲起。智能体安全指南也提醒我们,不可信的指令和私人数据同样在这个问题里面。
掌声可以等一等。我想先看看,演示结束以后,谁还坐在桌前。