01 · AI Circularity Ledger
Model Olympics的裁判由誰評判?
一個帶著記分板的商業循環。
結論很清楚:Model Olympics應該公開一部評測憲法,交代任務、權限、證據、評分,以及挑戰結果的權利。Dark Forest則作為改變激勵條件的實驗場。排行榜可以吸引注意力;可復現的制度,才能把注意力轉化為有用的研究。
每張模型排行榜背後,都藏着另一個模型:它的裁判。裁判可能是語言模型,也可能是測試集、數學驗證器、人工評審,或者一套決定哪些失敗應被計分的規則。投資者和經營者首先應問:這個分數究竟是怎樣產生的?
昨天,我們討論AI裁判能否被替換。今天再走一步:梳理評測機構的關係,並提出開放競賽如何連接這些環節。本文交付研究與設計方案,沒有宣佈新的公開軟件、已經完成的Dark Forest賽季,或已獲獨立復現的結果。
評測版圖有四層
任務庫定義考什麼;執行框架決定怎樣考;裁判判斷證據;治理制度規定誰能改規則、檢查失敗、提出異議。四層相互影響,若全部壓成一個名次,真正有用的差異就消失了。
HELM將不同場景與指標組織起來。EleutherAI評測框架提供可複用的執行工具。Inspect將數據集、求解流程與評分器拆開。這些工具可以互補;選定框架,並不等於已經決定業務需要什麼。
| 層次 | 實際問題 | Model Olympics方案 |
|---|---|---|
| 任務 | 覆蓋什麼能力和人羣? | 公佈題型、排除範圍與來源 |
| 執行框架 | Agent實際能做什麼? | 固定工具、預算、版本及介入規則 |
| 裁判 | 哪些觀察算成功? | 保留客觀結果,另列主觀評分 |
| 治理 | 誰能檢查並挑戰結果? | 公佈關係、規則變更與申訴記錄 |
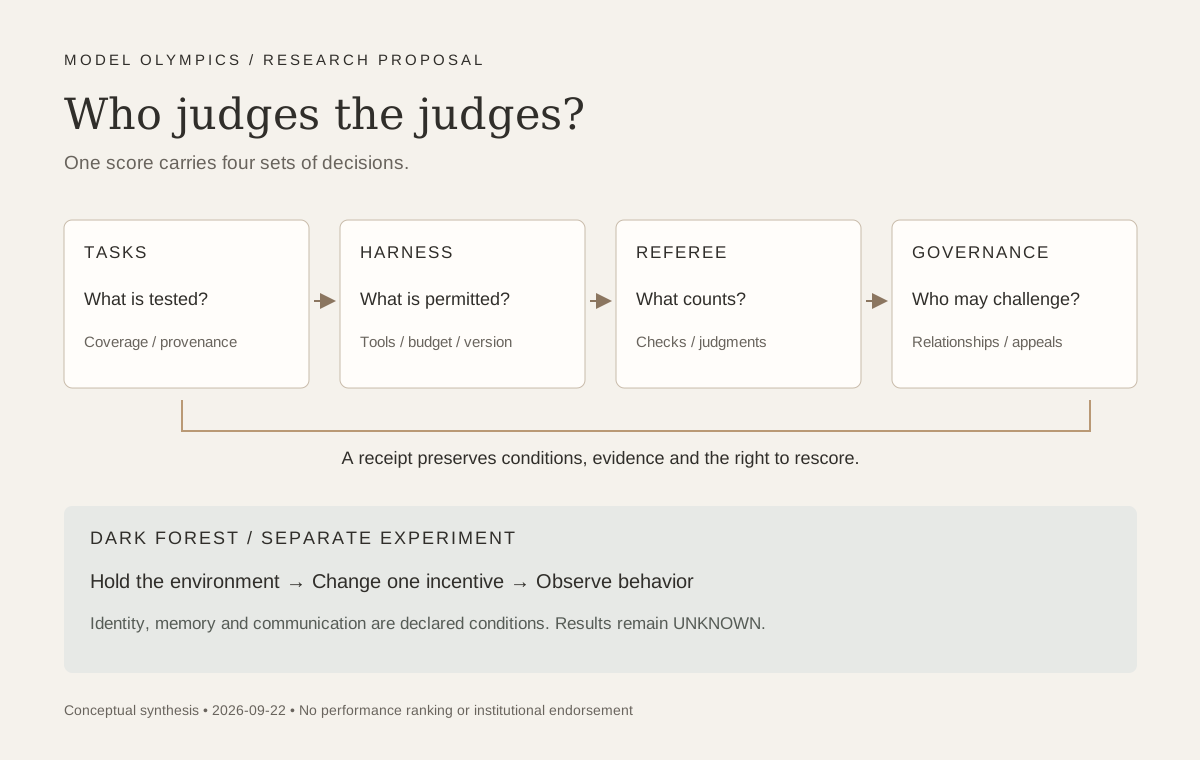
原創概念圖。箭頭表示擬議的證據流程,不代表實測成績或相關機構的背書。
一個Benchmark可以跨越多層。SWE-bench Verified測試代碼倉庫修復,人工篩題與可執行測試又共同決定什麼纔算修復成功。FrontierMath Open Problems提出可用程序檢查候選答案的數學問題。METR則提供機構層面的評估與研究。將三者都稱為排行榜,會抹掉支撐結果的機制。
經營者需要的評測記錄,應接近自己準備購買的工作。擁有廣泛終端權限的編程成績,不能直接代表權限受限的支付助手。經人工多次救場才完成的答案,也不能按無人值守的工作定價。成績必須連同運行條件一起交付。
把機構關係放在結果旁邊
現金資助、免費算力、提前訪問模型、共同開發、所有權和發表權,是六種不同的關係,各自產生不同依賴。披露關係有助於理解激勵與訪問條件,單憑關係本身,不能認定結果被操控。
Epoch在本次核查時表示,OpenAI是Open Problems驗證器訪問權限的唯一買家;同時說明,OpenAI曾資助最初的FrontierMath各層級,而Open Problems由Epoch獨立開發並全資擁有。因此,訪問權限、歷史資助與現有所有權必須分欄記錄。Epoch披露。
METR聲明沒有接受AI公司資金,同時使用大量免費Token;官網也說明了與前沿實驗室的合作。現金來源獨立,與模型訪問依賴被評估者,可以同時成立。METR披露。
OpenAI說明曾與原作者共同開發SWE-bench Verified。Anthropic在9月18日宣佈直接資助Accenture的嵌入式評估。Google DeepMind提供開放研究套件Melting Pot。這些制度安排各不相同,不能統一歸為同一種獨立審計關係。SWE-bench、Anthropic、Melting Pot。
擬議披露卡還應追問:誰選擇模型版本?誰能延遲發表?誰能看到失敗記錄?贊助方能否撤回訪問權限?公開文件沒有回答的,就填UNKNOWN。空白不能變成獨立性證明;商業關係也不能在缺乏證據時變成指控。
一次規則變更,足以改變進步的含義
2026年9月16日,Epoch新增human + AI類別,用於AI發揮關鍵作用、卻並非自主完成的解題成果。頁面上只是一個標籤,能力判斷卻因此不同。帶日期的變更記錄。
對Model Olympics而言,啓示是把人工協助作為正式觀察項:誰給過提示,誰改過計劃,誰修過環境,誰挑選了最終答案?人機協作成果當然可以有價值;協助過程可見,價值纔算得清楚。
假設Agent最初理解錯了約束,經人提醒後提交了有效答案。最終產物通過檢查,但這次運行沒有證明自主解題能力。客戶仍可能願意購買這種組合流程,前提是評測說明需要多少人工時間,以及介入屬於哪一種工作。
規則版本也應有持久標識。委員會若修改“AI解題”的定義,應同時保留舊分類、新分類及變更原因。否則,表面上的能力提升可能部分來自重新貼標籤。持續演進的Benchmark,既需要新題,也需要記憶。
裁判也要參加考試
原始MT-Bench研究記錄了語言模型裁判的位置偏差、偏好冗長及自我偏好,也發現其與人類偏好具有實用的一致性。這些發現告訴我們應測什麼,並不證明今天所有裁判都以相同程度出錯。原始研究。
Model Olympics可以固定候選答案,每次只改變一個評分條件:顛倒答案順序,隱去模型名,比較事實內容相同的長短版本,或改寫評分提示而不改變原意。公佈哪些判決因此改變,包括合理的人類評審也會分歧的邊界案例。
一致率必須有分母。共同評審案例中判決一致的比例,要說明如何處理平局、棄權和裁判調用失敗。簡單題上一致,不代表爭議題也可靠。只公佈總分,恰好掩蓋了最能幫助改進規則的樣本。
“共謀”更要慎用。輸出相似、共同訓練影響,或同一種評分錯誤,都可能造成一致,卻沒有協調行為。Dark Forest可以設置受控溝通機會,再移除通道進行比較。在實驗區分這些解釋之前,共謀只是待檢驗假說。
裁判還必須位於參賽者權限之外。候選答案可能自稱應該得高分,這屬於被審查材料,不能授權修改規則或調用外部工具。最基本的防線,就是把提交內容與支配裁判的指令清楚分開。
確定性驗證也有邊界
可執行測試能證明產物滿足已編碼的條件,不能自動證明這些條件覆蓋整項工作。通過軟件測試與滿足用戶需要有關,卻有不同的覆蓋範圍。
驗證器仍可能存在Bug、漏掉案例,或採用比讀者想象更窄的假設。因此,競賽應固定驗證代碼版本,說明已知覆蓋範圍,並保留爭議樣本。修復檢查器後,保留舊結果,發佈帶標記的重評分,不能悄悄改寫歷史。
客觀與主觀結果應分欄:產物是否執行成功?是否遵守約束?運行成本多少?說明是否有用?綜合分可以幫助瀏覽,但讀者必須能還原組成部分,看到權重如何選擇。
這樣,分歧纔有建設性。裁判喜歡文風,不能推翻執行失敗;產物正確,也仍可因說明不清受到批評。不同用戶可以對同一證據採用不同偏好,而無需改寫發生過的事實。
公開憲法,封存決賽題
Model Olympics應公開題型、示例、框架接口、權限、評分代碼與申訴流程。可復現回執應綁定任務版本、模型標識、配置、工具事件、輸出、成本及裁判決定。研究者創建分叉時,應能準確指出自己改了哪個環節。
決賽題可以封存至事先聲明的公開時點。這樣既能保護未污染的測量,又不必把規則藏起來。預先承諾決賽集及其選題程序,賽後公開可披露的材料,讓外界檢查比賽有沒有為贏家臨時改題。
僅有開源代碼,無法保證託管模型表現可重複。供應商可能改變端點,服務可能下線,採樣也會產生差異。回執應區分“回放已保存證據”與“重新調用模型”。兩者各有用處,名稱不能混用。
可分叉還需要許可證、接口說明與一個小型可運行示例。一堆日誌屬於檔案;另一人能夠理解並挑戰的精簡材料包,纔開始成為基礎設施。私人商戶資料、憑據與真實運營軌跡不應進入公開示例,可以用合成任務展示完整契約。
Dark Forest改變激勵條件
Melting Pot提供了研究社會互動、以及向陌生參與者泛化的參考。它研究多Agent強化學習,不構成擬議語言Agent版Dark Forest行為的驗證;兩種環境之間能否遷移,需要實測。
首個擬議賽季可以固定環境,只改變一項事先聲明的獎勵條件。一組條件下,共同目標讓所有Agent受益;另一組中,個人獎勵可能與集體表現衝突。實驗要問的是:合作變得有代價後,行為怎樣變化?不能憑一段合作對話就認定穩定的“性格”。
身份與記憶是另外兩個實驗維度。一組保持身份穩定,另一組改變標籤;比較每輪重啓與明確允許跨輪記憶的情況。必須規定每位參與者能觀察、能保留什麼,否則記憶優勢、身份泄漏或額外溝通渠道,都可能被誤認成更強的社會推理。
合作、背叛與恢復,需要在開賽前定義成可測行為。記錄資源分配、有效承諾、實際行動及整體結果。自述可以幫助解釋軌跡,卻不能覆蓋事件日誌。獎勵變更須按實驗規則告知;若研究突然變化,意外性本身應作為獨立變量。
這是一項有邊界的合成環境方案,不授權在真實市場部署欺騙型Agent、聯繫他人、轉移資金或公佈私人日誌。關鍵問題是行為能否隨受控激勵變化而改變。精彩的背叛故事,替代不了這組比較。
先交付一個材料包,再談宏大排名
第一個有用的里程碑很小:一個題型、一份權限契約、保存的輸出、一個客觀檢查器,以及兩個可替換的主觀裁判。看結果之前固定驗收規則,事先決定哪些案例需要人工裁決,並保留約定樣本範圍內的全部嘗試。
裁判實驗用相同的已保存答案比較判決。Dark Forest實驗則匹配環境條件,只改變一個激勵。這兩項實驗要分開:重評軌跡檢驗裁判;更換獎勵後重跑參與者檢驗行為。若同時改兩件事,歸因就變得困難。
監測表可記錄回執完整度、客觀結果可復現性、裁判分歧、人工介入分鐘、成本及未結申訴。本文沒有把任何數值門檻冒充成熟標準;具體目標應寫入未來的實驗契約,並在看到結果前選定。
發佈門檻應包括乾淨的合成材料包、明確的再分發權利,以及一次外部復現嘗試。今天,那次嘗試的結果仍為UNKNOWN。若復現失敗,只要能指出哪項假設出了問題,材料包仍然有價值。這正是開放制度應歡迎的反饋。
我們邀請研究者挑戰首個擬議Dark Forest賽季,並在規格完成審查後創建分叉。本文沒有宣佈新的可下載賽季。當前交付的是版圖、披露結構與實驗設計;軟件發佈和實測結果各自需要證據。
什麼才值得投入?
對一人公司而言,稀缺注意力應放在真正改變經營決策的少數評測條件上。本地語言支付任務、不熟悉的交易對手,以及嚴格的工具權限,可能比寬泛排名更重要。公開憲法讓小型經營者解釋自己的選擇,無需聲稱訓練出了前沿模型。
對資本配置者,同樣的紀律可以區分實驗室新聞與能夠產生收入的工作流:換一組任務、換一位裁判,再計入人工介入成本,質量是否仍然成立?經濟問題是獲得可信結果需要付出多少,包括修復異常的代價。
Model Olympics的價值,在於讓人們用證據處理分歧。Dark Forest的價值,在於把激勵變化變成可測實驗。下一項可信主張因此很剋制:另一人能夠檢查材料包、更換裁判,並準確告訴我們,哪個結論依然成立。
分類與關鍵詞
分類: 人工智能;評測治理;開放研究。
關鍵詞: Model Olympics;Dark Forest;評測框架;LLM-as-a-judge;封存決賽題;可復現回執;激勵設計。
Hashtags: #ModelOlympics #DarkForest #AIEvaluation #OpenResearch #AgenticAI