01 · AI Circularity Ledger
Model Olympicsの審判を誰が評価するか
スコアボードを備えた商流。
結論は明確だ。Model Olympicsは、課題、権限、証拠、採点、異議申立ての権利を定める「評価の憲法」を公開すべきだ。Dark Forestは、報酬条件を変える実験場に位置づける。ランキングは注目を集める。再現できる制度があれば、その注目を研究に変えられる。
モデルのランキングには、隠れたもう一つのモデルがある。審判だ。言語モデルの場合も、テスト群、数学的検証器、人間の審査員の場合もある。何を失敗として数えるかという設計自体が審判になることもある。投資家や事業者が最初に問うべきは、この点数が何から生まれたか、である。
昨日はAI審判を交換できるかを論じた。今日は評価機関の関係を整理し、公開競技が各要素をどう結ぶかを提案する。本稿の成果は調査と設計だ。新たなソフトウェア公開、Dark Forestシーズンの完了、独立した再現実験の成功を発表するものではない。
評価を四つの層に分ける
課題集が試験内容を定め、実行基盤が受験条件を決め、審判が証拠を評価する。ガバナンスは、誰が規則を変え、失敗を調べ、結果に異議を申し立てられるかを定める。この四層を一つの順位に押し込めると、判断に必要な違いが消える。
HELMはシナリオと指標を整理する。EleutherAIの評価基盤は再利用できる実行機構を提供する。Inspectはデータセット、解答生成の処理、採点器を分離する。これらは補完的な道具であり、基盤を選んだだけで事業上の評価目的が決まるわけではない。
| 層 | 実務上の問い | Model Olympicsの提案 |
|---|---|---|
| 課題 | どの能力と利用者を対象にするか | 課題群、対象外、出典を公開 |
| 実行基盤 | エージェントは何を実行できたか | 道具、予算、版、介入条件を固定 |
| 審判 | どの観察を成功と認めるか | 客観結果と主観評価を別々に保持 |
| ガバナンス | 誰が検証し異議を出せるか | 関係、改定、申立ての記録を公開 |
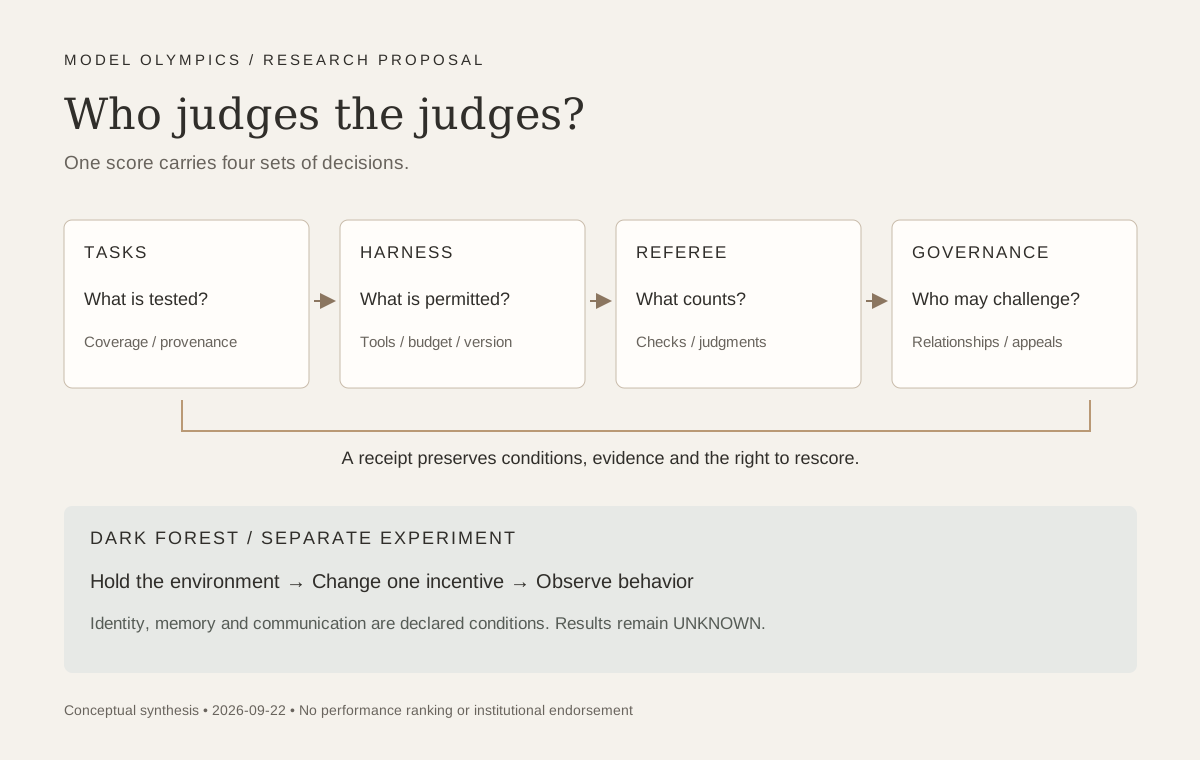
独自の概念図。矢印は提案する証拠の流れを表す。実測成績や各機関の支持を示すものではない。
一つのベンチマークが複数の層にまたがることもある。SWE-bench Verifiedはリポジトリの修正を扱い、人による課題選別と実行テストが成功の意味を左右する。FrontierMath Open Problemsは候補解をプログラムで検証できる数学問題を扱う。METRは組織として評価と研究を行う。すべてをランキングと呼ぶと、結果を解釈するための仕組みを見失う。
事業者に必要なのは、購入する仕事に近い条件の評価記録だ。広い端末権限を与えたコーディング成績を、権限の狭い決済助手にそのまま当てはめることはできない。人間が何度も救済した回答を無人運転の仕事として値付けすることもできない。成績には実行条件を添える必要がある。
結果の横に関係を開示する
資金提供、無料計算資源、モデルへの早期アクセス、共同開発、所有権、発表権は、それぞれ異なる関係だ。開示から分かるのは利害やアクセスへの依存である。関係があるという事実だけでは、結果が歪められた証拠にはならない。
確認時点のEpochの説明では、OpenAIはOpen Problems検証器へのアクセスを購入した唯一の主体だ。一方、最初のFrontierMath各層にはOpenAIの資金が入り、Open ProblemsはEpochが独立開発し単独所有すると区別している。アクセス、過去の資金、現在の所有権は別欄に記録すべきだ。Epochの開示。
METRはAI企業から資金を受け取っていないとしつつ、大量の無料トークンを利用している。主要研究所との協力も説明している。現金の独立性と、評価対象が供給するアクセスへの依存は両立し得る。METRの開示。
OpenAIは原著者とSWE-bench Verifiedを共同開発したと説明する。Anthropicは9月18日、Accentureによる組み込み型評価に直接資金を出すと発表した。Google DeepMindは公開研究基盤Melting Potを提供している。異なる制度上の関係を、同じ独立監査関係として扱う根拠はない。SWE-bench、Anthropic、Melting Pot。
提案する開示票では、モデルの版を選ぶ者、発表を遅らせられる者、失敗記録の閲覧者、アクセス撤回の権利も問う。公開資料で答えが得られなければUNKNOWNとする。空欄を独立性の証明に変えてはいけない。同様に、商取引の存在を根拠のない疑惑へ変えるべきでもない。
規則が変われば進歩の意味も変わる
Epochは2026年9月16日、AIが不可欠な役割を果たしたものの自律的には解かなかった成果にhuman + AIという区分を加えた。小さな表示変更でも、能力の主張には大きな違いが生じる。日付付き変更履歴。
Model Olympicsでは、人の支援を正式な観察項目にするべきだ。誰がヒントを出し、計画を修正し、環境を直し、最終回答を選んだかを記録する。人とAIの協働には価値がある。その支援が見えれば、価値も評価しやすくなる。
仮にエージェントが制約を取り違え、人間に指摘されて正しい成果物を出したとする。成果物は合格でも、自律的解決を証明したことにはならない。顧客はその組み合わせに対価を払うかもしれない。必要な人の時間と介入内容が分かっていれば、合理的な判断ができる。
規則の版にも永続的な識別子が要る。委員会がAIによる解決の定義を変えた場合、旧分類と新分類を理由とともに残す。そうしなければ、見かけの性能向上にラベルの変更が混ざる。進化するベンチマークには、新しい問題だけでなく記憶も必要だ。
審判自身を試験する
初期のMT-Bench研究は、言語モデルによる審査に位置、冗長さ、自己選好の偏りがあることを示し、人間の選好との有用な一致も報告した。これは検査すべき項目の根拠であって、現在の全審判が同じ程度に失敗するという証明ではない。原研究。
実務的には回答を固定し、採点条件を一つずつ変える。回答順を逆にする。モデル名を隠す。事実内容が同じ短文と長文を比べる。意図を保って採点指示を書き換える。判定が動いた事例を、妥当な人間同士でも意見が分かれる境界例とともに公開する。
一致率には分母が必要だ。共同採点した件数のうち一致した割合を示す際、同点、棄権、呼び出し失敗をどう扱ったかを明記する。簡単な事例の一致だけでは、争点の多い事例の信頼性は分からない。総計だけを示すと、規則の改善に役立つ材料が隠れる。
共謀という言葉も慎重に使いたい。出力の類似、共通の学習要因、同じ採点ミスは、協調なしでも一致を生む。Dark Forestでは管理された通信機会を設け、その経路を取り除いた条件と比較できる。複数の説明を区別する実験が済むまでは、共謀は仮説である。
審判は参加者の権限の外側に置く。提出回答に、自分を高く評価するよう求める文章があっても、それは審査対象だ。規則の変更や外部ツールの実行を許可する指示ではない。提出内容と判定を支配する命令の分離が、最も基本的な防御になる。
決定的な検査にも範囲がある
実行テストが証明できるのは、コード化された条件を成果物が満たしたことだ。その条件が仕事全体を網羅するとは限らない。テストへの合格と利用者の満足には関係があるが、検証範囲は異なる。
検証器にはバグ、抜けた事例、読者の想定より狭い前提があり得る。競技では検証コードの版、既知の範囲、争いのある事例を保存するべきだ。検査器を直したら旧結果を残し、再採点と分かる形で発表する。履歴を静かに置き換えてはいけない。
客観結果と主観評価は別欄に置く。成果物は実行できたか、制約を守ったか、費用はいくらか、説明は有用か。合成スコアは閲覧を助けるが、内訳と重みを読者が確認できることが条件になる。
この分離があれば、意見の違いを活用できる。文章を好む審判も、実行失敗を取り消すことはできない。正しい成果物でも、説明の悪さは批判できる。利用者は同じ証拠に異なる選好を適用でき、起きた事実を変える必要がない。
憲法を開き、決勝問題を封じる
Model Olympicsは課題群、例題、基盤のインターフェース、権限、採点コード、異議申立て手順を公開するべきだ。再現用記録は課題版、モデル識別子、設定、ツール操作、出力、費用、判定を結び付ける。フォークした研究者が、何を変えたかを正確に示せる状態を目指す。
決勝問題は、事前に定めた公開時点まで封印できる。規則を秘密にせず、汚染されていない測定を守るためだ。問題群と選定手順を事前に確定した証拠を残し、終了後に公開可能な材料を開示する。勝者に合わせて試験を変更していないかを、第三者が点検できる。
コードが公開されても、ホスト型モデルの動作が再現される保証はない。提供元がエンドポイントを変え、サービスを終了し、サンプリングが揺れることもある。保存済み証拠の再生と、モデルの再実行を記録上で分ける。どちらも有用だが、同じ名前にはできない。
フォークにはライセンス、インターフェースの説明、小さな実行例も必要だ。大量のログはアーカイブである。他者が理解して異議を唱えられる小さな資料一式が、インフラの出発点になる。商店の個人情報、認証情報、実運用記録は公開例に含めず、合成課題で契約を示す。
Dark Forestでは誘因を変える
Melting Potは、社会的相互作用や未知の参加者への汎化を評価する先行例になる。ただし、多エージェント強化学習の研究である。提案する言語エージェント版Dark Forestの挙動を検証したものではなく、設定間の移行は実験が必要だ。
最初のシーズン案では環境を固定し、事前に宣言した報酬条件だけを変える。一方では共通目的への貢献が各参加者の利益になる。他方では個人報酬と集団の成果が衝突し得る。協力が割に合わなくなると何が変わるかを問う。協力的な会話から安定した性格を読み込まない。
識別名と記憶は別の実験軸だ。一方は同じ識別名を保ち、他方はラベルを変える。毎回初期化する条件と、明示的に許可したラウンド間記憶を比べる。各参加者が何を見て保持できるかを定めないと、記憶の差、身元の漏れ、追加通信が社会的推論の優位に見えてしまう。
協力、裏切り、回復には、競技前の操作的定義が要る。資源配分、有効な約束、実行した行動、集団全体の結果を記録する。自己説明は解釈に役立つが、イベント記録を上書きできない。報酬変更は実験規則に従って知らせる。予期しない変更を研究するなら、驚き自体を別変数にする。
これは範囲を限定した合成環境の提案だ。現実の市場で欺くエージェントを動かし、人に接触し、資金を動かし、私的ログを公開する権限は生まれない。重要なのは管理された誘因変更で行動が変わるかである。劇的な裏切りの物語では、その比較を代替できない。
大きな順位表より小さな資料一式
最初の有用な到達点は小さい。一つの課題群、一つの権限契約、保存した回答、一つの客観検査器、交換可能な二つの主観審判だ。結果を見る前に合格条件を固定し、人の裁定が必要な事例を決め、対象サンプル内の全試行を残す。
審判の研究では同じ保存回答の判定を比べる。Dark Forestでは環境を対応させ、誘因を一つだけ変える。両実験は分ける。保存軌跡の再採点は審判を試し、別報酬で参加者を再実行することは行動を試す。二つを同時に変えると原因の特定が難しい。
監視票には、記録の完全性、客観結果の再現性、審判の不一致、人の介入時間、費用、未解決の異議を載せられる。本稿は数値目標を確立済みの標準とは主張しない。目標は将来の実験契約に書き、結果が出る前に選ぶ。
公開条件には、整理された合成資料、再配布の権利、外部による再現の試みを含めるべきだ。その試みの結果は現在UNKNOWNである。失敗しても、壊れた前提を特定できれば価値がある。公開制度が求めるべきフィードバックは、まさにそれだ。
研究者には最初のDark Forestシーズン案への批判と、審査後の仕様のフォークを呼びかけたい。本稿で新しいダウンロード可能なシーズンを発表してはいない。今の成果は地図、開示構造、実験設計である。ソフトウェア公開と実測結果には、それぞれ証拠が必要になる。
何を作る価値があるのか
一人企業の限られた注意は、経営判断を変える少数の評価条件に向けたい。地域言語の決済課題、未知の取引相手、狭いツール権限は、広範なランキングより重要かもしれない。公開憲法があれば、小さな事業者も、自ら最先端モデルを訓練したと主張せずに選定理由を説明できる。
資本配分でも同じ規律が、研究所の見出しと収益を支える業務を分ける。課題や審判を替え、人の介入費用を加えても品質は維持されるか。経済上の問いは、例外処理まで含めて信頼できる成果にいくらかかるかだ。
Model Olympicsが有用になるのは、権威より証拠で意見の違いを扱えるときだ。Dark Forestが貢献するのは、誘因の変化を演出から測定へ移すときだ。次の信頼できる主張は控えめでよい。他者が資料を点検し、審判を交換し、どの結論が残るかを正確に示せることだ。
カテゴリーとキーワード
カテゴリー: 人工知能、評価ガバナンス、公開研究。
キーワード: Model Olympics、Dark Forest、評価ハーネス、LLM-as-a-judge、封印した決勝問題、再現用記録、誘因設計。
Hashtags: #ModelOlympics #DarkForest #AIEvaluation #OpenResearch #AgenticAI