03 · Daily Special · Signal 1
アラームは受領証ではない
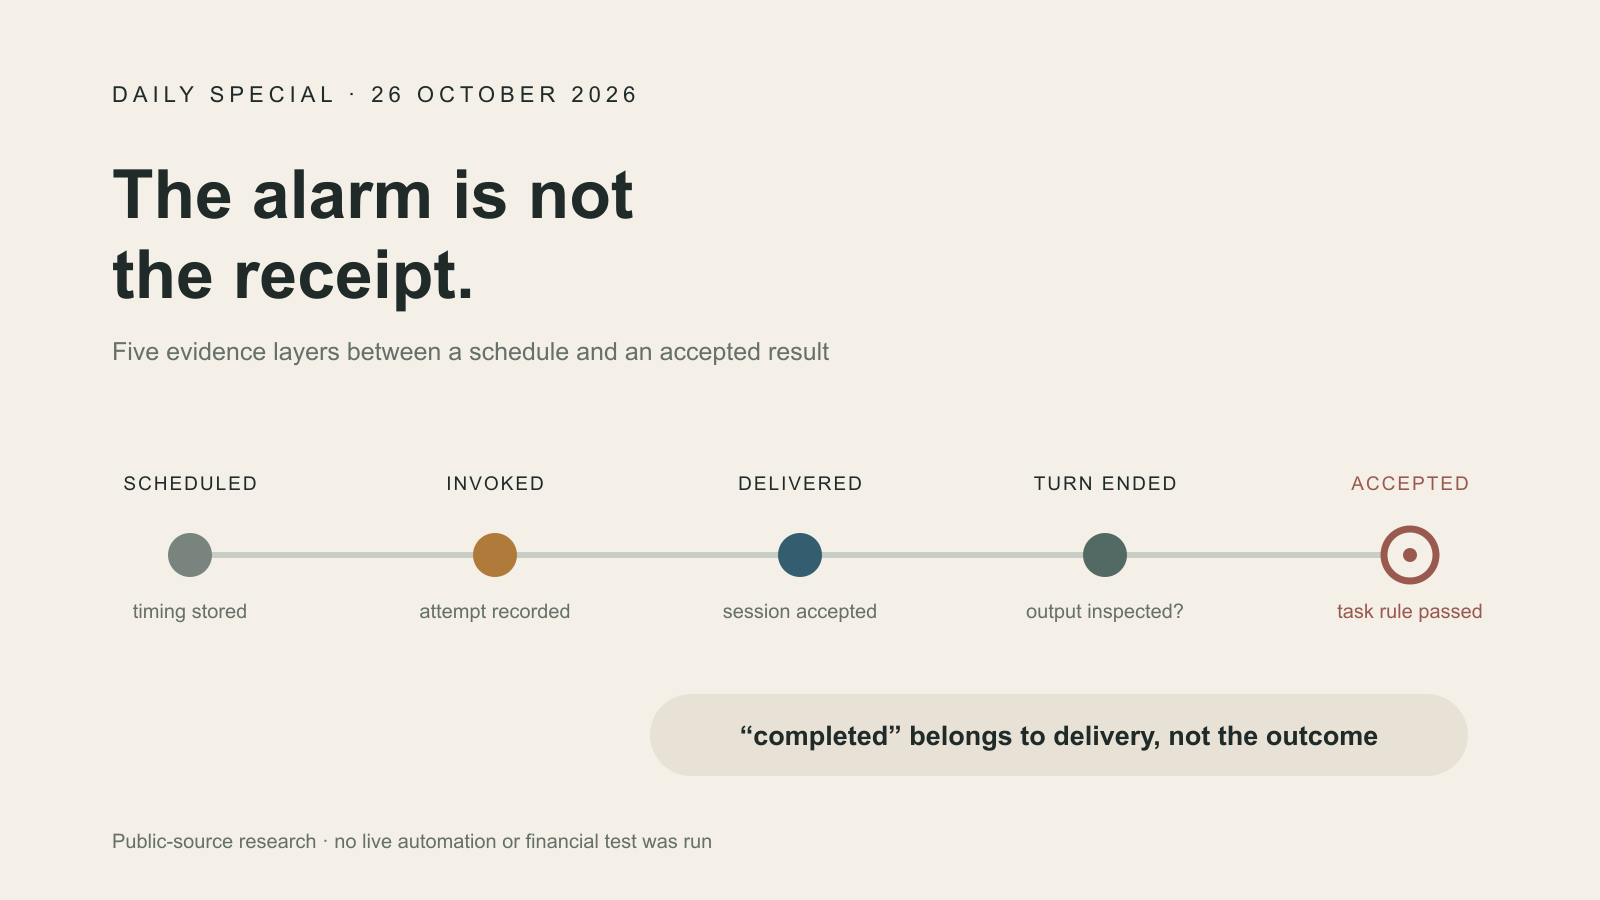
OpenAI Agents APIのスケジュール、invocation、セッション、ターンの証拠がそれぞれ何を示すかを公開情報で限定的に調査する。ライブ自動化やQuant前向きテスト、取引、資本配分、メッセージ送信、基礎となる意思決定は行わない。
08:00、アラームが鳴る。新しい invocation が現れ、ステータスが緑になる。
日次ノートは現れない。
これは、スケジュール型エージェントにある小さくも重大な隙間だ。システムは、仕事が完了したこと、正しく完了したこと、受け入れる価値があることを証明するよりずっと前に、仕事の配送を試みたことだけは証明できる。
OpenAIのAgents API文書は、これらの出来事を分けている。スケジュールは定期でも一回限りでもよく、新しいセッションを始めることも、既存セッションを続けることもできる。各回は invocation、つまり仕事を送ろうとする試みを作る。配送に成功すると、その invocation は completed になる。
この言葉の意味は、響きより狭い。ここで completed が示すのは、セッションが最初の入力、通知、または要求を受け入れたことだけだ。エージェントが仕事を終えたことではない。
ステータスが間違っているのではない。その意味を超える証明をステータスに求めるダッシュボードが間違っている。
意味の違う五つの緑信号
証拠を階段として考えると分かりやすい。
- Scheduled。 有効なスケジュールがある。まだ何も発火していないかもしれない。
- Invoked。 その回の invocation が作られた。配送に成功したとは限らない。
- Delivered。 invocation が completed になった。セッションは仕事を受け入れたが、エージェントが終えたとは限らない。
- Turn ended。 セッションイベントでルートターンの完了、失敗、取消が分かる。個別ツールは失敗しているかもしれず、副作用がすでに起きている場合もある。
- Accepted。 この仕事のために書かれた検査が、成果を使用可能と判断する。
最初の四段はプラットフォームの証拠だ。五段目は仕事の所有者に属する。マーケットノートが完全な入力を使ったか、レポートが約束した日付を覆うか、生成ファイルが所定のスキーマとハッシュに合うかを知るのは、その所有者だけだからだ。
この区別は分母を変える。「配送済み invocation/invocation」は輸送を測る。「受入済み成果/予定回数」は結果を測る。どちらも正直に報告できるが、答える問いは違う。
緑の実行が何も残さないとき
08:00に動く調査ジョブを想像してみる。これは説明用であり、実際に行った実行ではない。
invocation は配送され、セッションが受け入れる。エージェントは二つの情報源を読み、関数結果、環境接続、または承認が必要なツールに到達する。スケジュール通知はそのどれも供給できない。実行は待ち始める。
監視が配送を成功と扱えば、その時点で誤りだ。アイドル状態を成功と扱えば、もう一度誤る。アプリケーションはセッションイベントを追い、ルートターンの結果を確認しなければならない。
ターン完了でさえ全回答ではない。内部のツールが失敗しているかもしれない。もっともらしい段落が、欠けた情報源の上に書かれていることもある。失敗したターンでもファイル変更やツール呼び出しを済ませている可能性があり、盲目的な再試行は作用を重複させる。
開始前から時刻がずれることもある。OpenAIによれば、定期実行には小さなランダム遅延が入り、対象セッションが忙しければ invocation はさらに待つ。したがって予定時刻は意図であり、厳密な実行時刻の証拠ではない。時刻に敏感な調査では、遅延は見た目の問題ではなく入力品質の問題になり得る。
スケジュールに受入判定を結ぶ
最も単純な修復は、証拠を結合する一つの記録だ。ここでは「受入証跡」と呼ぶ。
これは編集上の提案であり、OpenAIの機能や要件ではない。予定回、invocation、セッション、ルートターン、最終成果物を結び、この定時起動が実際に何を達成したのかに答える。
重要な仕事なら、私は次を記録する。
- スケジュールと意図した実行回;
- invocation と配送結果;
- セッションとルートターンの終端状態;
- 欠けた入力と失敗したツール;
- 成果物の時刻、スキーマ検査、ハッシュ;
- 再試行、リプレイ、人による救済;
- 暫定的な使用量と費用;
- 仕事固有の判定:受入、拒否、未完了、または救済済み。
使用量には特に節度が必要だ。文書では使用量はベストエフォートとされ、null の場合があり、ターン後に変わることもあり、最終請求でもない。空欄は証拠不足であって無料ではない。
証跡は仕事に比例させるべきでもある。外部への作用がない読み取り専用ジョブなら、成果物の存在、スキーマ、ハッシュだけで足りるかもしれない。ファイルを書き、ツールを呼び、後続処理を起こすジョブには、より強い台帳と上限付き再試行が必要だ。証跡そのものもソフトウェアであり、作り過ぎれば新たな故障面になる。
リプレイは役立つが、答えられる問いは限られる。固定入力は実行間のばらつきを示せる。複数回が同じ答えでも全て間違うことはあるため、正しさや将来性能の証明にはならない。
この調査が証明していないこと
これらの定時自動化について、公開された分母付き信頼率、遅延分布、総費用ベンチマークは見つからなかった。このSpecialではライブ自動化もQuant前向きテストも実行していない。取引、資本配分、メッセージ送信、基礎となる意思決定も行っていない。
ここで完成した仕事はもっと小さい。出典確認済みの、証拠の境界図だ。起動はイベントであり、受入は判断である。その間には配送、実行、ツール結果、成果物、そして結果が十分かを決める規則がある。
次に定時エージェントがダッシュボードを緑にしたら、動いたかだけを問わない。最後の隙間を、どの証拠が越えたのかを問いたい。
注記と情報源
OpenAIの文書には、スケジュール型自動化、セッションイベントとルートターン、トレース、トレース評価、暫定使用量、エラー復旧と上限付き再試行が説明されている。完全な調査資料には、この記事で使った証拠図と限界を保存した。