03 · Daily Special · Signal 1
仕事は終わった。それでも復旧は失敗しているかもしれない
公開一次資料に基づき、一回の読み取り専用ツール・タイムアウトを対応比較する手順を設計し、正しい納品と状態喪失、二重処理、人の救援、復旧コストを分ける。実験自体は実施していない。
エージェントがツールのタイムアウトにぶつかった。少し止まり、再試行し、最後は指定されたフォルダにファイルを置いた。画面には緑のチェックが灯る。
めでたい。ところで、いったい何が復旧したのだろう。
最後に信頼できた状態から再開したのかもしれない。仕事を最初からやり直しただけかもしれない。誰かが重要な一文をそっと与えた可能性もある。さらに困るのは、同じメッセージを二度送り、同じ支払いを二度行い、三倍のトークンを使ったのに、全員が最後のチェックしか見ていない場合だ。
仕事が終わっても、復旧は失敗していることがある。
今日の問いは小さい。一回だけ意図的にタイムアウトを起こしたとき、長時間動くエージェントについて何が分かるのか。たどり着いたのは六つの証跡を残すテストカードだった。一万のエージェントが何日も走る風景ほど派手ではない。その代わり、緑のランプだけでごまかすのは難しい。
ハーネスも作業者の一部である
OpenAIによるThird Moment Researchの紹介には、36〜48時間続く調査が登場する。興味深い仕組みはモデルだけではない。外側のハーネスが未完了の軌跡を調べ、再試行するか、終了するか、人へ引き継ぐかを決める。
同じ紹介には、もっと日常的で、少し可笑しい失敗もある。バックテストに何時間もかかるため、エージェントは終了したかどうかを何度も確認した。「まだ着かないの?」と繰り返す子どものように、トークンを使い、その確認で文脈まで埋めていった。記事によれば、キャッシュと記憶の持ち方を直した結果、約3時間の処理が3〜5分に短縮された。
ここで舞台裏が表に出る。粘り強さは、モデルの中に浮かぶ性格ではない。タイムアウト、チェックポイント、再試行、文脈管理、停止条件、待つコストの組み合わせで決まる。つまり、ハーネスも作業者の一部だ。
OpenAIの評価指針も同じ点を明確にしている。道具、再試行、採点方法、資源予算を変えれば、測られる性能も変わり得る。統制した比較をするなら、課題、採点、予算を固定し、試行回数、時間、費用、周辺設定を示す必要がある。
だから「最後まで終わったか」だけでは足りない。問うべきは、「同じ予算の同じシステムが、この故障の後も正しい状態を十分に保持し、正しく終えられたか」である。
問いは小さくなった。その分、答えられるようになった。
双子を作り、一方だけ転ばせる
まず、客観的な合格条件を持つ読み取り専用の仕事を選ぶ。固定した公開資料から報告書を作り、必要な主張、リンク、納品先、ファイルのハッシュを先に決める、といった仕事でよい。入力、モデル、指示、ハーネス、道具、予算、合格条件を固定する。
次に、双子の実行を用意する。
- 対照側は故障を入れずに実行する。
- 注入側は、あらかじめ選んだツール呼び出しで一度だけ、決められたタイムアウトを受ける。
ほかの条件をこっそり良くしてはいけない。注入側だけ親切な指示にしたり、予算や再試行を増やしたり、人が耳元でヒントを伝えたりすれば、測っているのは復旧ではない。救援の請求書に別の名前を書いただけだ。
Microsoftの信頼性テスト指針は、明確な仮説、通常時の基準、限定した影響範囲、中止とロールバックの手順を求めている。故障時の指標は通常時と比較する。最初の試験を読み取り専用の固定環境で行えば、転ぶのは実験であって顧客ではない。
一組の比較から復旧率は出せない。エージェントにはばらつきがあり、長い仕事には多くの分岐がある。一つの物語を法則にしてはいけない。GoogleのSREテスト指針も、故障を一度再現しただけでは修復を証明できないと説明する。ログや乱数種は経路の再現に役立つが、統計的な主張には反復が要る。
それでも一組には価値がある。測定の仕組みが動くかを確かめ、一つの復旧経路を端から端まで観察できる。
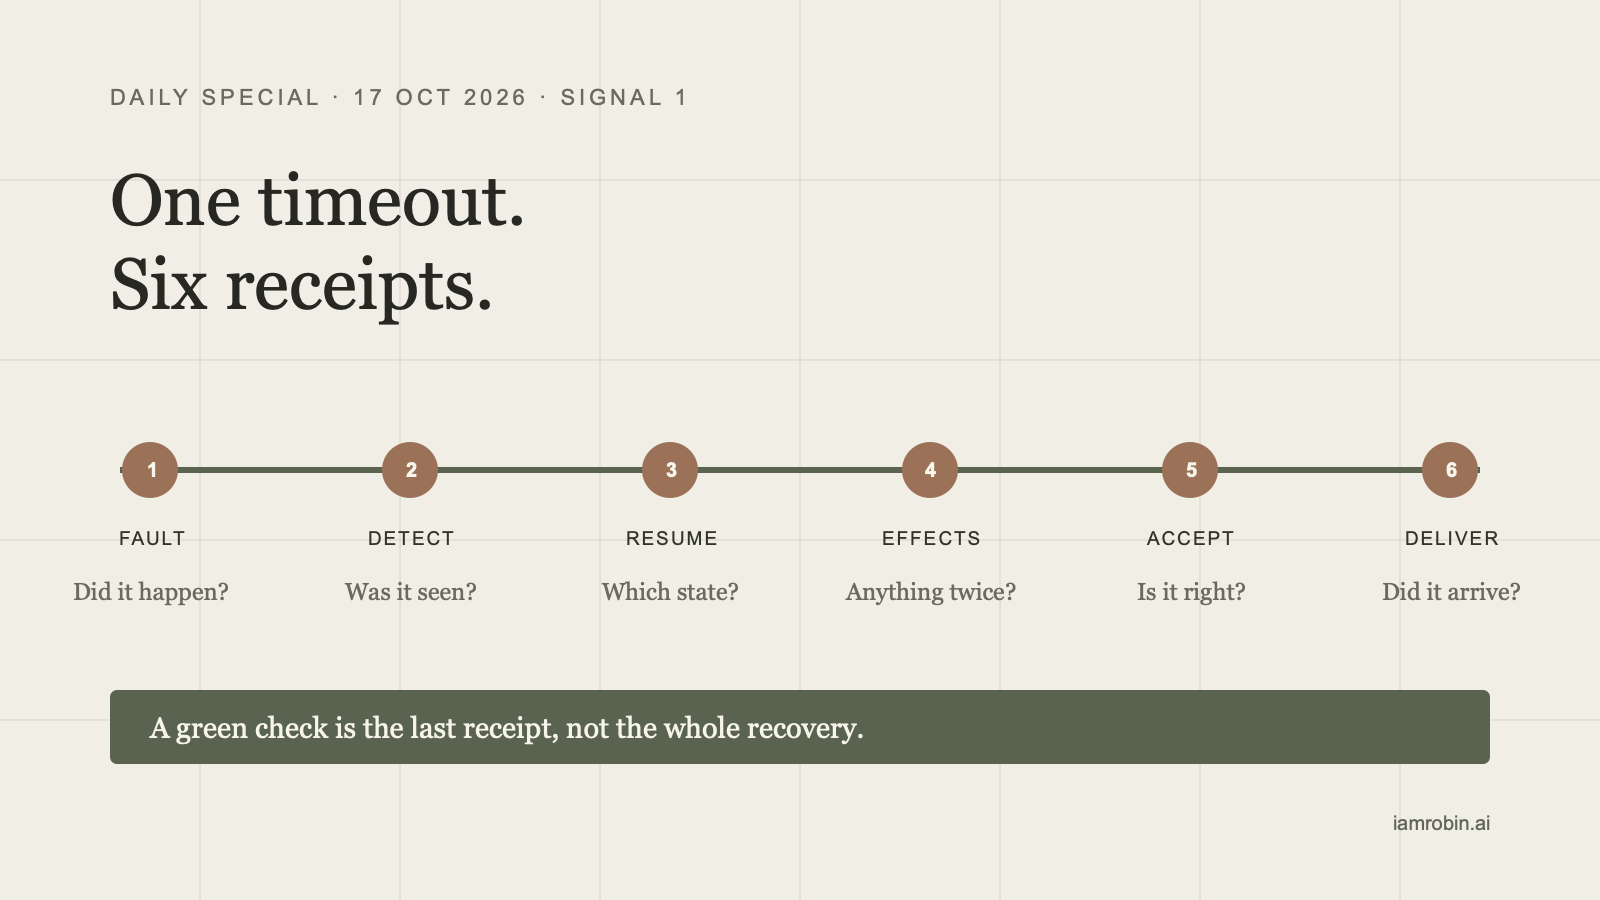
六つの証跡を求める
第一は、故障そのものの記録だ。どの呼び出しに、どの応答を、いつ、どれだけの時間注入したかを残す。これがなければ、単に遅かった要求が、後から勇敢な障害訓練に化けてしまう。
第二は検知である。どのトレースが最初にタイムアウトを認識したのか。ハーネスは再試行可能、終了すべき、人へ渡すべき、のどれに分類したのか。目を閉じて同じボタンを押すことは、診断ではない。
第三は再開状態だ。どのチェックポイントを信頼したのか。そこから続けたのか、最初からやり直したのか。やり直しでも正しいファイルは作れるが、それが示すのは再起動性であって、状態を保った復旧ではない。前半の仕事が高価だったり、すでに外部操作があったりすれば、この差は大きい。
第四は副作用の台帳である。最初の試験では外部への書き込みを止める。次の段階では冪等性キーや操作IDを使い、再試行が送信、課金、予約、公開を二重に行わないようにする。「終わったから良し」は、二枚目の請求書が来ると急に魅力を失う。
第五は合格の証拠だ。出力を見る前に書いたテストを実行し、主張、ハッシュ、重要な不変条件を確認する。終了コードがゼロなのは、プロセスが礼儀正しく止まったという意味にすぎない。仕事の正しさまでは保証しない。
第六は納品である。約束した場所から成果物を読み戻し、バイト単位で照合する。手元での成功と、相手に価値が届くことは、親戚ではあるが双子ではない。
六つを並べると因果の背骨ができる。故障が起き、システムがそれを認識し、既知の状態から再開し、危険な操作を二重にせず、結果が合格し、成果物が本当に届いた、と確認できる。
復活劇に値札を付ける
ここで初めて双子を比べる。両方について、実時間、呼び出し回数、トークン、直接費用、人が能動的に使った時間を残す。注入側では、故障から検知までと、故障から合格した納品までの時間も測る。
差分が、この一組で観測された復旧税になる。10秒のタイムアウトが12秒の遅れで済むこともあれば、40分を加え、仕事全体のやり直しを招くこともある。人の手が不要な場合も、誰かがログから記憶を組み立て直す場合もある。どれも同じ緑のチェックを表示できるが、中身はまったく違う。
人の時間も分けて考えたい。救援は通常の確認ではない。質問への回答は承認ではない。待機は能動的な調整ではない。全部を一つの数字に入れると、自律性はストップウォッチを持つ人次第で上下する。
結果は四種類に分けられる。エージェントが自力で復旧し、合格した成果を届ける。人が救援し、成果は合格する。不確かな状態を認めて正しく停止し、使える引き継ぎを作る。あるいは、復旧に失敗し、予算を超え、処理を二重にし、納品を確認できない。
自律的な復旧と呼べるのは最初だけだ。二番目は人の助けを含む合格。三番目は優れた判断になり得るが、仕事の完了ではない。四番目こそ、試験をした理由である。
一度のタイムアウトで得られるもの
注入側がタイムアウトを検知し、検証済みのチェックポイントから再開し、同じ予算内で、二重処理も人の救援もなく、合格した成果物を届けたとする。これは確かな証拠だ。
ただし証明したのは、一つの経路が一度うまく働いたことだけである。
八時間の仕事全般で調整負担が減るとはまだ言えない。より大きな主張には、事前に決めた複数の故障位置と乱数種で比較を繰り返し、次に実際の仕事を代表する課題群へ広げる必要がある。失敗と未解決の実行も分母に残す。ハーネスや再試行予算を変えたら、新しい比較として扱う。
一万の並行エージェントに比べれば、保守的に見えるかもしれない。私はむしろ、こちらの方が野心的な習慣だと思う。規模は活動を壮観にする。小さく厳密な対応比較は、戻ってきた機械が同じ事実、同じ権限、予想した請求額を持ち帰ったかを教えてくれる。
今日完成したのは試験手順であり、実験ではない。八時間の仕事は走らせず、本番に故障を注入せず、経路を変えず、資金を使わず、運用判断もしていない。次の一歩を別途選ぶなら、内容は明快だ。一つの読み取り専用タスクを固定し、双子の片方だけ転ばせ、拍手の前に六つの証跡をそろえる。