01 · AI Circularity Ledger
エージェントを増やしても一緒に失敗する理由
スコアボードを備えた商流。
百人のアシスタントを雇い、全員に同じ表計算ファイルを渡す場面を想像してほしい。一つのセルに誤った為替レートが入っている。全員が熱心に計算し、互いに答えを照合して、見事に整った、全員一致の企業価値評価を提出する。
買えたのは合意だ。誤りへの備えまで買えたかどうかは、誰が元の表を確認したかで決まる。
架空の例だが、AIを前提に動く企業には実務的な問いになる。エージェントを一つ加えると、従来のチームでは耐えられなかったどの失敗に耐えられるのか。別の声は新しい推論を示すかもしれない。別の観測は、最初の声が見ていなかった事実を見つけるかもしれない。この二つは異なる投資であり、組織は何を買うのか理解しておきたい。
実務上の結論はこうだ。エージェントを増やせば、検索を分担し、別々のファイルを扱い、異なる証拠を調べられる。一方で、同じ誤りへの確信を増幅することもある。運用上の論点は、設計の中に独立した仕事と独立した確認がどれだけあるかだ。
チームも一つの盲点を共有する
架空のアシスタントたちが異なるモデルを使っているとしよう。安心材料に見える。しかし全員に同じ誤ったレートを渡し、表を信頼するよう指示し、同じ受入基準を使わせれば、表現は違っても失敗は一致する。モデルを替えることで扱えるのは、依存関係の一種類にすぎない。
今度はモデルを同じままにし、情報経路を変える。一人は表を読み、もう一人は別の原典からレートを取得して、日付と通貨ペアを確認する。もちろん、両者が相場表示の慣例を誤解したり、信頼できない情報源を使ったりする弱点は残る。それでも、元の誤りを発見する具体的な機会は増えた。「二つのモデルなら安全」という説明より、設計上の意味が明確だ。
独立性は、情報の経路に沿って点検する性質である。証拠はどこから来たか。どの変換が数字を生んだか。成功条件は誰が決めたか。どのツールが結果を書き込むか。百の会話がすべて一つの依存先の下流にある場合もある。会話数だけでは、負荷や障害に対するその依存先の振る舞いは分からない。
全員を互いに隔離したいわけではない。協力には情報共有が必要だ。チーム全体を崩し得る少数の共通前提を特定し、それを黙って引き継がない観測経路や停止条件を設けることが目的になる。
小さな海が実際に示したこと
公開中のAgent Swarm Labには、自己修復への楽観に問いを投げる例がある。Ocean Swarmでは、模擬小型艇が観測地点を覆い、海流、エネルギー制約、通信遅延が計画を乱す。局所修復規則は、空いていると判断した地点に余剰艇を移す。権限を限定した母船も修復を提案できるが、同じ制約付き通信を通さなければならない。
通常の子ノード損失後、固定配置の平均観測地点稼働率は77.24%、局所修復では80.70%だった。複合障害では局所修復が75.65%となり、固定配置の77.15%を下回った。各条件24シードの対応付きシミュレーション結果であり、公開手法にモデル、比較、限界を残している。
注目したいのは優劣の逆転だ。艇が失われたときに役立つ仕組みでも、空きを推定する証拠が不確かになると悪化を招き得る。遅れた報告もモデル世界の一部であり、修復先と、それによって置き換えられる有用な仕事を変える。
これは言語モデルの誤りが相関することを示した実験ではない。Oceanは合成的な協調モデルであり、実海域試験も、継続推論するエージェントもない。示せるのは、復旧機構を加えても全障害条件で改善するとは限らない、という限定された反例だ。AI組織にこの問いを移すには別の試験が要る。
別の実験は別の箱に入れる
同じラボのMinimum Intelligenceでは、実際のモデル呼び出しで計画を作成し、その後に物理的結果を再生した。結果記録には、三つのモデル世界で333回の呼び出しが成功したとある。計画は固定され、モデルは実行中の後発の衝撃を観測せず、再計画もしない。
この区別によって、言えることが変わる。固定計画が再生に耐えたという結果は、その再生内の計画と実行規則の証拠である。常駐するAIの働き手が現場の予期せぬ事態から復旧する能力を測ったものではない。呼び出し成功は応答が返ったことを示し、各計画の優位性を保証しない。
また、分区プランナーの比較では、情報の集約方法と協調方法が同時に変わると研究自身が注意している。十の分区プランナーと百の局所プランナーの差を、エージェント数だけに帰すことはできない。安価に見える構成は、良い情報や別の分解方法、あるいは両方の恩恵を受けている可能性がある。
ラボのすべての件数を、一つの大きく印象的な数字にまとめる必要はない。テスト、物理的結果、モデル呼び出しは異なる問いに答える。分母を分ければ、他の作り手がどの結論に異議を唱え、何を追加検証すればよいか理解しやすくなる。
失敗は組織を通って移動する
研究文献は、この設計問題を表現する言葉を与えてくれる。Cemriらのマルチエージェント失敗研究は、観測された失敗をシステム設計、エージェント間の不整合、タスク検証に整理する。チームが目的を見失う場所は複数あり、人数を足しても自動的に直るわけではない。
例えば、誤った問いに対する精密な答えは、レビュー担当も同じ誤った仕様を受け継いでいれば、何段階も通過する。正しい観測も、渡す相手を間違えれば役に立たない。中間結果が正しくても、本当の完了条件を誰も検査しなければ、納品物は受け入れられない。
Huangらの故障エージェント研究は、意図的に混入した誤りと協調構造の相互作用を調べる。メッセージと確認の配置を問う根拠にはなるが、現在の全モデル、全業務、全企業に最適な組織を決める結果ではない。
これらは過去の研究であり、十月の新製品発表ではない。ここでの価値は方法にある。運用者は、誤りがシステム内をどのように通るかを調べるべきだ。表計算の架空例、模擬海洋、言語モデルの協調はそれぞれ別の環境だが、誤情報が承認された行動に変わる場所を問う点は共通する。
群れを描く前に共通の依存先を描く
組織図を見ると箱の数を数えたくなる。失敗の地図では、その箱が何に依存するかを問う。証拠、ツール、記憶、受入条件、権限から始め、各作業者を実際の依存先につなぐ。原典と作業者の間に共通の要約役がいるなら、それも描く。
架空の企業価値評価では、レートのセルからすべての分析者へ矢印が伸びる。分析者の投票も、その矢印をたどれば同じセルに戻る。この地図なら、票を一つ増やすより独立したレート確認を加える方が、元の誤りへの備えになり得る理由が見える。複雑なモデル評価を始める前に確認できる依存関係だ。
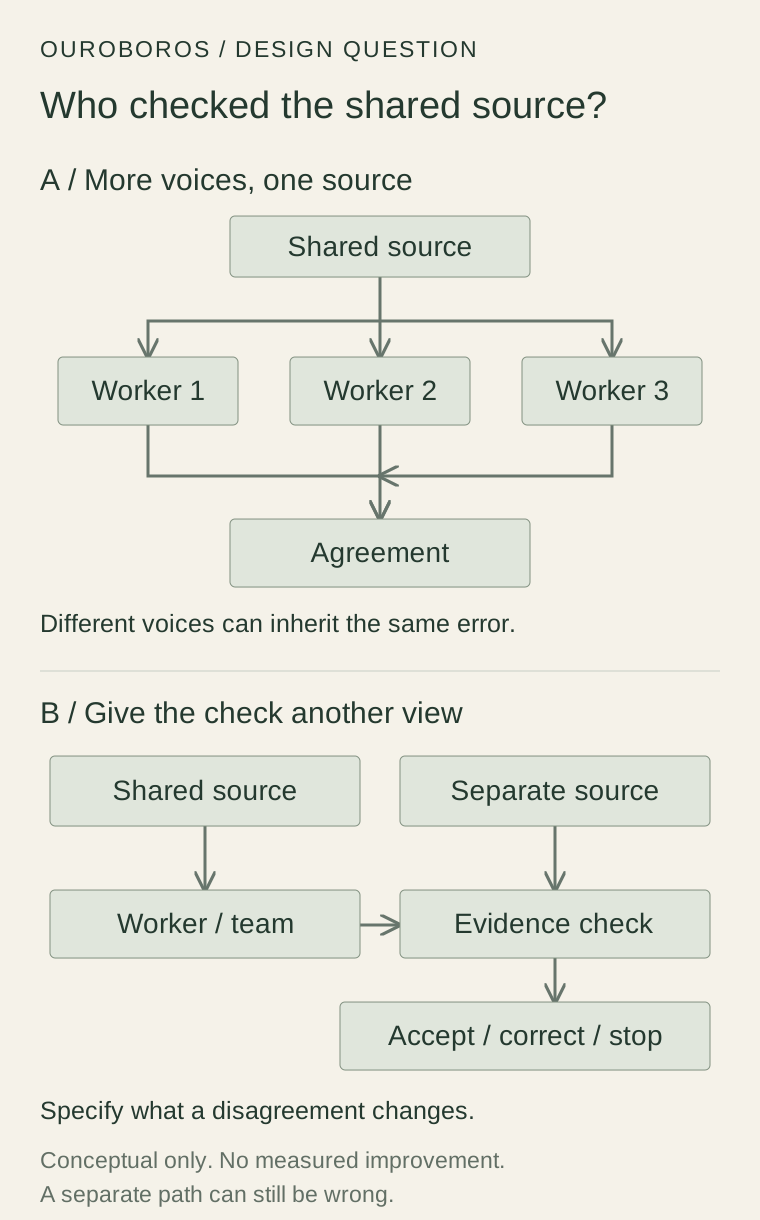
図は設計案であり、改善の実測値ではない。別のチェックも間違い得る。その利点は、別原典、別の観測手段、決定的な計算、あるいはエージェント自身の説明の外に置いた受入条件という、明確な違いから生まれる必要がある。
多様性の予算は、ここで正当化したい。新しいレビュー担当は何の誤りを見つけられるか。そのためにどんな情報を持つか。異議が出たら工程はどう変わるか。担当の名前が違うという答えしかなければ、役割は増えても保護策はまだ定義されていない。
異議の行き先を決める
文章をもう一段追加するだけの批評役は、結果を変えずに読む時間を増やす可能性がある。加える前に、異議の後を決めたい。修正に戻すのか、決定的な試験を走らせるのか、欠けた事実を示して停止するのか。停止を解除できるのは誰で、何を証拠とするのか。
架空の為替レートの争いに戻ろう。必要なのは、二つのレート、時刻、表示慣例、評価への感応度を残した記録だ。「反対する」だけでは弱い。同じセルを根拠にした「自信がある」は、さらに頼りない。
異議にも費用の上限がいる。何度もレビューすれば、小さな不確実性が終わらない会話になる。限定した手順なら、独立観測を一度求め、残った差を記録して、判断の境界を明示できる。これは運用規則の提案であって、全件が自動解決するという主張ではない。
全員が賛成している場合にも同じ規律が要る。該当する失敗を検出するよう設計された確認だけが、合意をもって完了できる。誰も行わなかった観測を、多数の承認で置き換えることはできない。成果を使う人には、欠けた観測が見えるべきだ。
気づく能力と行動権限を分ける
問題を発見する作業者に、本番環境を変更する権限まで必要とは限らない。調査助手がリンク切れを見つけ、公開工程が修正する。財務助手が仮定の不整合を見つけ、資本判断は所有者が担う。この分離なら、発見を役立てながら誤りの影響を知らないうちに広げずに済む。
レビュー担当は、観察力が強く、行動範囲が狭くてもよい。証拠を調べ、食い違いを保存し、候補が既定の基準を通過するのを止める能力があれば、被検査者と同じ認証情報を持つ必要はない。全員に同じ書き込み権限を渡すと、誤った指示がすべての実行先へ届くという、新たな共通依存ができる。
復旧にも具体的な境界が必要だ。最後に受入済みの成果を保管し、変化した証拠を特定し、次の試行と前の試行を区別する。メッセージが消えたら、受信側の証拠が得られるまで配達の成否を未確定に保つ。これは業務に応じた設計判断であり、無関係なアクセスや際限のない許可確認の理由にはならない。
小さな企業にとっての利益は、曖昧な引き渡しが減ることだ。所有者に届くべきものは結果、重要な限界、そして自分が決める必要のある明確な一点である。大きな群れが未決事項の山を大きくするだけなら、まだ存在価値を示していない。
一度に一つの依存関係を試す
次に実施するなら、こんな限定実験を組みたい。公開情報と固定した合成ケースを使う、無害な調査から草稿までの作業を選ぶ。単独作業者、同じ証拠パケットを共有するチーム、別原典で検証する工程を持つチームを比較する。結果を見る前に、タスク、ケース、受入基準を固定する。
共通パケットの一項目に既知の誤りを入れる。正常ケースも含め、全件拒否する仕組みが成功に見えないようにする。注入した欠陥と通常の難しさを区別し、どの群が独立観測を得られるか明示する。追加アクセスは処置の一部であり、隠れた優遇ではない。
受入済みの正答、受入済みの誤答、未解決ケース、経過時間、モデル使用量、人のレビュー分数を記録する。失敗と中断した試行も分母に残す。少数ケースでの実演が示せるのはその範囲であり、全モデルや全業務についての結論にはならない。
採用条件は先に書く。有用性が同程度で、受け入れてしまう誤りが減り、追加費用とレビュー負担が見えることだ。検証群が注入欠陥を見つけても正常ケースを悪化させたなら、その代償も結果に含む。単独作業者が要件を満たすなら、チームは追加の仕組みを正当化しなければならない。
この記事のために、この実験は実施していない。共有証拠と人数の効果を区別できる小ささに絞った、再利用可能な仕様である。問いを明確にするために、有料サービス、実アカウント、安全性への攻撃、本番変更は必要ない。
耐えられる失敗を一つ増やす
次にチームがエージェントの追加を提案したら、一文を求めたい。「この追加は、この証拠を観測でき、その発見がこの判断を変えるので、この失敗から私たちを守る」。五十人分の顔を増やした図より、ずっと情報が多い。
隣に短い運用カードを置く。共通依存、独立観測、受入責任者、許可された対応、測定結果を書く。試験前は結果を空欄にする。情報源、モデル、ツールが変わったら見直す。分かれていた経路が、気づかぬうちに再び共通化することがあるからだ。
並行作業が明確に勝つ仕事もある。一人の有能な作業者と強い外部確認の方が信頼しやすい仕事もある。設計の複雑さは、発見できた誤りと届けた有用な仕事によって正当化したい。
百人のアシスタントは強力なチームになり得る。全員一致を祝う前に、誰かが為替レートを確かめたか聞いてみよう。
カテゴリーとキーワード
カテゴリー: エージェントAI、システム、生産性。
キーワード: 共有された失敗、独立検証、エージェント協調、限定実験。
ハッシュタグ: #AgenticAI #SystemsThinking #AIProductivity #IAmRobin