01 · AI Circularity Ledger
インターフェースもモデルの一部
スコアボードを備えた商流。
二人の助手に顧客記録の更新を頼むとしよう。一人にはブラウザー、マウス、パスワードを渡す。もう一人には「顧客を更新する」という関数を渡す。後者が先に終えた。優秀な助手を見つけたのか。それとも、一人だけ廊下を短くしてあげたのか。
H Companyが9月28日に公開したHolo4は、この問いを身近にする。提供者はGUI、コード、MCP、APIを扱うモデルと説明する。一方、比較の注記には、ベンチマークの版、課題の部分集合、実行基盤の違いも記されている。システム全体を見るよいきっかけだが、私たちが対照実験を実施したことにはならない。Holo4 release
私の考えは単純だ。評価にはインターフェースも含めたい。エージェントを買うとき、買っているのは仕事を終える方法である。モデルはその一部だ。何が見え、何を実行でき、どの状態を完了とするか。それだけで、最初のトークンが出る前から結果は変わり得る。
短い廊下には価値がある
架空の顧客記録に戻ろう。ブラウザーの助手は名前を検索し、プロフィールを開き、編集操作を見つけ、項目を変更して保存する。関数を使う助手は識別子と新しい値を渡す。最終的な記録は同じでもよい。推論能力が同じでも、手間の差には商業的な価値がある。
関数が利用可能で、権限の範囲内にあり、信頼できるなら、企業はその節約を歓迎すればよい。競技を公平に見せるために、すべてマウスで操作させる経営は奇妙だ。調達試験は買い手が実際に運用できる環境を反映したい。統合のよさは、正当な製品の強みになる。
困るのは結論が広がるときだ。「この構成は私たちの業務をより安く終えた」は、適切な試験後なら言える。「このモデルは推論に優れる」には別の比較が要る。インターフェースが、失敗する機会をいくつも取り除いた可能性がある。そのシステム上の優位には、原因の名前を付けたい。
問いは二つになる。この仕事にはどの完成品を使うべきか。改善を生んだのはどの部品か。前者は導入を、後者は開発を助ける。顧客が変わる、連携機能がない、アプリが変わる。そのときも優位が残るかを考える手掛かりにもなる。
同じ画面でも見える情報は違う
ブラウザー同士の比較でも、同じウィンドウの画像を二枚並べるだけでは足りない。一方は画素だけを見る。もう一方はラベルや役割を含むアクセシビリティー情報も読む。第三の助手は保存された記録を直接検索する。同じアプリを使っているようで、状態を知る証拠が異なる。
架空の請求書業務で、参照番号が狭い列に隠れているとしよう。人なら列を広げられる。構造化テキストを読む助手は、最初から完全な番号を持っているかもしれない。視覚で操作する助手には、余分な手順を発見する必要がある。そこでの失敗はモデルだけでなく、観測経路の違いも映す。
BrowserGymは、対応する複数のブラウザーベンチマークに共通の研究環境を提供する。環境も仕様を定め、比較できる対象だと考える助けになる。ただし、同じライブラリーを使っただけで二つの実験が同条件になるわけではない。BrowserGym
私が提案する評価カードでは、モデル名の横に観測経路を書く。画像、アクセシビリティー情報、ツールの応答、ファイルを明示する。一方が追加情報を得るなら、製品比較ではその利点を残して表示する。原因を調べる比較では、実験上可能な範囲で両者に同じ関連証拠を与える。
一回のツール呼び出しに仕事が詰まっている
一回のクリックと一回のAPI呼び出しは数えやすい。しかし仕事量は大きく違い得る。クリックはメニューを開くだけかもしれない。一つの関数が顧客を検証し、複数項目を更新し、構造化された確認を返す場合もある。業務をどう分割するかで、ステップ制限の意味が変わる。
仮に各助手に十ステップを与える試験を考えよう。大きな機能を持つツールなら制限内で終わる。一方は画面移動の途中で時間切れになる。その成績はルールどおりでも、同じ業務を終える機会が等しかった証拠には乏しい。
動作数は残したい。軌跡を説明するからだ。同時に、経過時間、モデル使用量、ツール料金、人の注意も記録する。買い手には総費用と分かりやすい失敗経路が要る。開発者には、推論の反復が高いのか、インターフェースの選択が悪いのかを区別する情報が要る。
小さな会社の工夫はここにもある。反復業務のインターフェースを改善する方が、モデルを交換するより役立つかもしれない。統合と保守の費用を含め、個別の業務で検証する仮説だ。APIが常に勝つという約束ではない。壊れやすい連携は、短い廊下を開かない扉に変える。
完了には独立した欄が要る
ほぼ終わった仕事は、再生映像では見事に見える。報告書を作り、正しい顧客を開き、最後の項目も合っている。ところが別の版を保存する、あるいは提出しない。成功かどうかは受入条件で決まる。その条件は、点数を見る前に分かるようにしたい。
OSWorld 2.0の評価画面は、部分報酬と二値の完了を区別する。長い作業の進み具合と、要求された成果の完成は違う問いだ。ここでは方法上の背景として参照しており、過去のモデル成績を現在の順位として示してはいない。OSWorld 2.0
架空の顧客業務なら、正しい記録、要求どおりの変更、無許可の編集がないこと、独立に読める最終状態を完了条件にできる。「終わりました」という丁寧な応答は、助手がそう報告した証拠になる。合格には、アプリの実際の状態との一致が必要だ。
部分点にも役割はある。記録の発見、指示の解釈、最後の操作のどこで失敗したかを示せる。診断結果は最終合格率と並べて置けばよい。そうしなければ、デバッグ用の数値がいつの間にか経済価値の主張となり、未完了の仕事が買い手に残る。
公開課題と非公開課題は別の標本
さらに静かな比較上の問題がある。同じベンチマーク名でも、二つの報告が違う課題集を使うことがある。公開課題は開発に利用でき、保留された課題は汎化を測る。両方とも慎重に作られていても、点数は違う標本から得られる。
AutomationBenchは、公開課題と公式ランキングに使う非公開課題を明確に分ける。手元の点数が公式値にそのまま一致するとは限らないとも注意する。ベンチマーク名と一緒に課題集の区分を残す、具体的な理由になる。AutomationBench
別々の町で運転試験を受ける二人を想像してほしい。一方には複雑な交差点、他方には工事と仮設標識がある。百分率だけでは、同じ道で誰がうまく走れるか分からない。次に必要なのは条件をそろえた比較か、証拠に合わせて範囲を狭めた説明だ。
買い手は公表ベンチマークを候補選びに使える。最後の選択では、自社の許可された業務を代表する小さな課題集を重視したい。設定を決めた後の評価用に、いくつかのケースを保留する。不満な事例をすべて調整の機会に変えていけば、試験は徐々にリハーサルになる。
モデルが止まっていても採点器は進歩する
評価ルールはソフトウェアであり、仕様でもある。曖昧な指示、甘すぎる検査、実行ごとに変わる環境依存を含み得る。修正によって、モデルも行動も変わらずに点数が変わることがある。採点器の版も証拠の一部になる。
WebArena-Verifiedは、監査された課題と、エージェントの応答や記録したネットワーク履歴を使う決定的な評価を説明する。測定器自体を改善する具体例だ。ただし、その文書があらゆる顧客業務を保証するわけではない。個別の採点器が何を合格にするかは、なお確認が必要だ。WebArena-Verified
顧客記録の例なら、目標項目だけを見る採点器は、別の記録を誤って変えたことを見逃すかもしれない。ほかの記録が変わっていないか確認すれば、試験は厳しくなる。点数低下は以前からあった問題の発見であり、突然の知能低下と呼ぶのは誤解を招く。
そこで、採点器の改訂、初期状態、期待する最終状態を結果と一緒に保存したい。ルール変更時は関連比較を再実行するか、旧結果は旧ルールのものと明記する。昨日の優勝者が今日の普通の受入検査に落ちる理由を説明するより、この記録作業の方が小さい。
比較を二つの経路に分ける
役立つ評価には二つの経路があると思う。第一は実際に使う完成構成の比較だ。同じ業務権限の範囲で、それぞれが対応するインターフェースを使えるようにする。統合、運用、確認の費用を含める。定義した仕事群に対して、利用可能なシステムのどれが適するかを答える。
第二は一度に一つの部品を変える比較だ。モデルを固定してインターフェースを変え、次にインターフェースを固定してモデルを変える。初期データ、指示、完了条件、資源制限を、差が解釈できる程度に安定させる。これは開発者の「何が改善を生んだか」に答える。
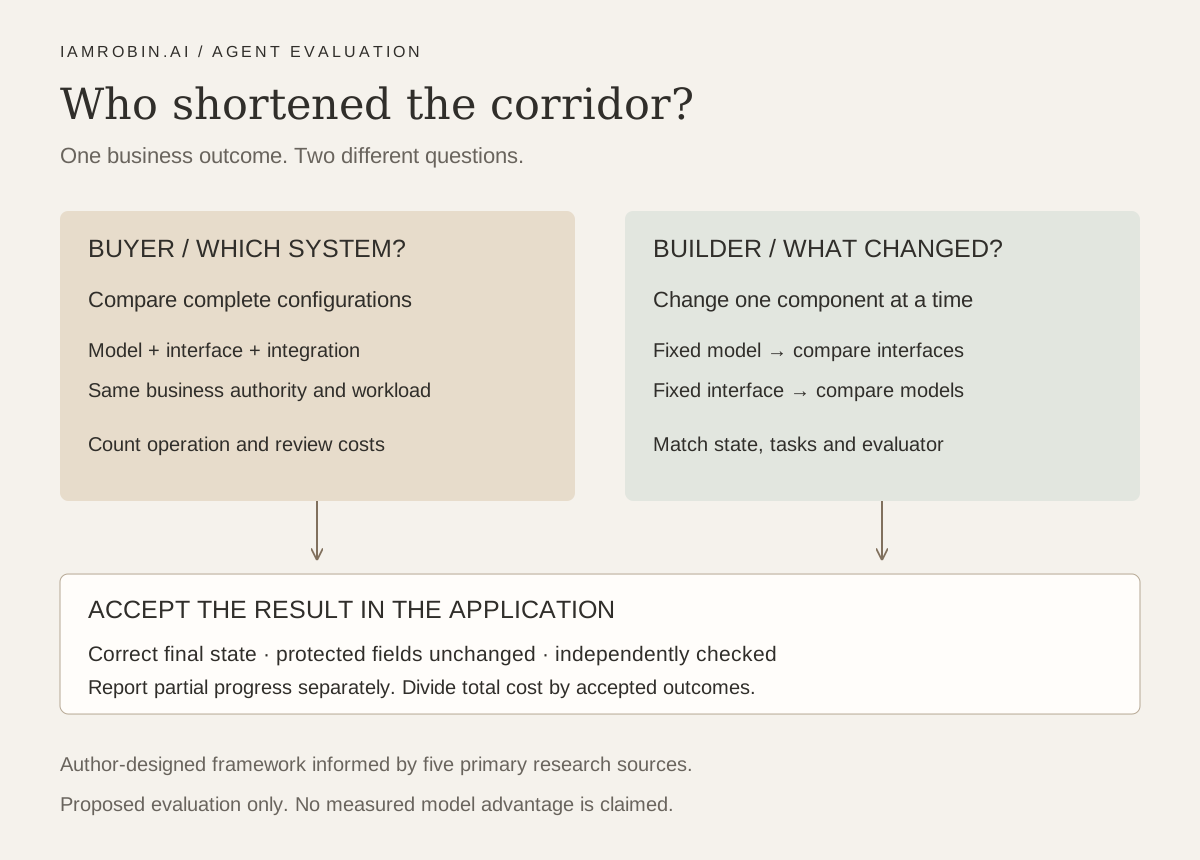
筆者が設計した概念的な比較枠組み。提案段階の評価であり、モデル実験や測定済みの改善を示す図ではない。
複数インターフェースを扱うシステムでは、各部分の仕事でどの経路を選ぶかも興味深い。選択には費用がかかり、失敗もある。正しい関数が分かればAPIを巧みに呼べても、画面操作が必要な場面を見分けられない場合がある。経路の選択と切替を、見えない配管扱いせず、軌跡に残したい。
制限は、単位を完全に同じにできなくても、意味を比較できるようにする。同じ金額、時間、ステップ数は異なる制約だ。問いに合うものを事前に選び、ほかの数量も併記する。気に入った候補の失敗を見てから、その候補だけ予算を増やしてはいけない。
完成した成果に小さな値札を付ける
数字を意図的に作った例を考える。構成Aは十件に20米ドルを使い、八件が合格した。構成Bは十件に12米ドルを使い、四件が合格した。統合費用と確認費用を入れる前なら、合格一件当たりは2.50米ドルと3.00米ドルになる。計算は20を8で、12を4で割るだけだ。
この例では、試行全体の支出が安い構成の方が、合格成果一件当たりは高い。Holo4や他製品の測定結果ではない。分母が重要な理由を示している。合格がゼロなら、その事実を報告する。都合のよい分母に置き換え、有限の成功単価を作ってはいけない。
Aには高価な統合が必要で、Bは担当者が数分で保守できるとすれば、選好はまた変わり得る。固定費は現実的な数量と寿命に配賦し、人の確認にも明示的な費用仮定を置く。現金支出と推計労務費は区別して示す。読み手が自分の条件で計算し直せるようにするためだ。
普遍的に最も安いエージェントが、この式の中に隠れているわけではない。特定の仕事量、期間、受入条件で魅力的かもしれない構成がある。その狭い結論の方が、請求書を払う人には役立つ。
最初の実験は一枚に収めたい
次の一歩として、合成した顧客記録だけを使う、未実施の受入演習を提案する。少数の更新課題を固定する。曖昧な名前、存在しない記録、変更禁止項目も含める。同じ模擬状態に二つの許可されたインターフェースを用意する。実顧客にも外部送信にも触れない。
勝者を選ぶ前に成功を定義する。変更が正しく、保護項目は変わらず、最終記録を独立に確認できること。意図的に不可能または曖昧にしたケースでは、適切な拒否や確認質問を合格にする。自信を持って別のアカウントを変えるシステムは、不足情報を指摘するシステムより低く評価したい。
完成品の比較と部品の対照比較は分ける。失敗軌跡も保存し、費用、所要時間、介入、合格を記録する。見かけの優位が一度の幸運かを見られる程度にケースと実行を重ね、結果と限界を一緒に公表する。本稿はその作業の提案であり、実施報告ではない。
監視ルールも小さい。モデル、インターフェース、業務内容、採点器が実質的に変わったら選択を見直す。新しい接続機能は新モデルと同じくらい重要かもしれない。権限の削除で旧性能の主張が無効になる場合もある。顧客の課題が変われば、旧勝者は以前の仕事に弱くならなくても、適さなくなる。
短い廊下の先にいる助手を雇うのは、よい判断かもしれない。誰が廊下を短くしたかを書き残そう。説得力のある実演が、他人も使える結果になる。
分類とキーワード
分類:エージェント基盤、企業ソフトウェア、評価。
キーワード:コンピューター操作エージェント、インターフェース選択、条件をそろえた評価、完了条件、合格成果一件当たりの費用。
ハッシュタグ: #AgentInfrastructure #ComputerUse #Evaluation #IAmRobin