01 · AI Circularity Ledger
AI審判を誰が評価するのか
スコアボードを備えた商流。
結論は明快だ。AI審判への信頼は、別の人が審判を置き換え、何が変わるかを確かめられることから生まれる。Model Olympicsは、その異議を実際の研究に変えるべきだ。見栄えのよいランキングは入口であり、長く残る資産は審判をめぐる不一致にも耐える記録である。
同じ課題を終えた二つのエージェントを想像してほしい。一方は簡潔な結果を出し、もう一方は長い説明を自信満々に語る。言語モデルは後者を選んだ。本当に成果が優れていたのか、それとも審判が好む文体だったのか。さらに主催者が勝ったモデルを販売していれば、組織の利害という別の問いが生じる。二つを混ぜると、どちらも見えにくくなる。
本稿はDark Forestを含むModel Olympicsの開かれた評価設計を提案する。公開リポジトリの発表、新たな大会結果の報告、RobinOSの私的会話記録の開示ではない。今日の成果物は、他者を評価する仕組みになる前に、読者が異議を唱えられる設計である。
審判には二つの異なる問題がある
Anthropicは9月18日、Accentureによる組み込み型評価を発表し、当初は自社が直接費用を負担すると説明した。アクセス、公表、長期資金の基準は未確定だ。ここでの課題は、評価者が不都合な事実を調査し、報告するための制度的保護である。直接支払いは管理すべき依存関係であり、特定の評価が歪められた証拠ではない。発表。
モデル審判には測定上の問題がある。MT-Benchの原著論文は、提示順、冗長さ、自己優遇などの偏りと推論上の限界を記録した。答えの見せ方や審判の変更によって選好スコアが変わり得る理由になる。ただし、後のすべてのモデルが同じ偏りを持つとも、人間の評価が無謬だとも示していない。MT-Bench論文。
競技場では二つの記録を分けたい。制度の記録には資金、所属関係、選任権、公表規則を記す。測定の記録には評価モデル、プロンプト、採点基準、回答順、出力を残す。独立組織でも弱い基準を使うことはあり、技術的に良い基準でも利益相反のある報告過程で使われ得る。それぞれに異議を扱う経路が必要だ。
昨日の「誰が審判に払うのか」に、今日は運用上の問いを加える。参加モデルの回答を作り直さずに、読者が審判を入れ替えられるか。可能なら、異論のあるスコアは具体的な研究対象になる。不可能なら、自信に満ちた順位が検証できない選択に依存しているかもしれない。
観察できる結果はルールで判定する
まず直接確認できる部分から始める。プログラムは指定テストを通ったか。行動はゲーム規則に適合したか。予算を超過したか。これらは明示した受け入れ条件と、版管理するルールエンジンで判定する。説得的な説明が、客観的チェックの失敗を密かに覆してはならない。
決定論的判定も誤る。テスト自体が間違い、環境が制約を見落とし、採点が抜け道を報いることもある。エンジンを開く目的は、その欠陥を点検可能にすることだ。修正時は新しいルール版と結果を作り、旧記録を残して解釈の変更理由を説明する。
判断が必要な部分には、言語モデル評価を併記する。明瞭さ、交渉の質、有用性には複数の妥当な解釈がある。評価者の判断だと表示し、元の回答を保存する。別の審判は、客観結果を消さずに異論を述べられる。
結果表には課題の成否、規則違反、審判の評価、未解決事項を別々に載せる。将来、宣言済みの総合スコアを設けても、読者が算出過程を再構成できることが条件だ。成功と権限外行為の関係を一つの数字で隠すなら、集計そのものが評価の弱点になる。
場を開いても、手札まで先に見せる必要はない
Dark Forestでは情報の扱いが中心になる。規則が公開されていても、参加者が異なる私有情報を持つゲームは成り立つ。開始前に隠れた状態をすべて公開すれば、測るゲームが変わる。規則まで秘密にすれば、外部は競技の整合性を判断できない。開示には時間の設計が要る。
提案する構造では、公共ルール、各エージェントに許された観察、完全なイベント記録を分ける。競技中に見せるのは役割上許された情報だけだ。終了後は、審査済みの再生パッケージに合成状態を収め、意思決定を再構成して結果を点検できるようにする。実在の私的情報は含めない。
例として資源配分の仮想ラウンドを考える。二つのエージェントには異なる需要予測を示し、提案回数を制限する。規則は提案の拘束力、資源の移転、終了条件を定める。後から行動の適法性は点検できるが、記録されていない動機まで知ったことにはできない。欺瞞をめぐる興味深い物語も、証拠がなければ解釈にとどまる。
各判断時点で何が見えていたかを公開記録に含める。その記録がなければ、意外な行動の原因が戦略、プロンプト漏洩、単なる操作ミスのどれか分からない。原因ごとに対策は違う。これは実験構造の提案であり、そのラウンドが完了した、または公開審査を通ったという主張ではない。
再現には三つの意味がある
第一は、保存イベントから環境を再構成することだ。同じ初期状態と記録済みの合法行動から、決定論的エンジンは同じ最終状態を得るはずである。検査対象はシミュレーションと採点だ。エンジン版、初期状態、完全な時系列イベントが必要になる。
第二は、保存回答を別の審判で再採点することだ。参加者は新たに作業しない。読者が審判や基準を変え、結論がどこまで残るかを見る。FastChatの公開手順はモデル回答と評価出力を別に保存しており、この分離の具体的な参考になる。LLM Judgeの説明。
第三は、エージェント自体を再実行することだ。乱数シードを固定しても、ホスト型モデルの応答が同一になるとは限らない。提供者の変更、非決定論的な計算、旧版モデルの利用不能が追試に影響する。制約を明記し、イベント再生の成功を新規エージェント実行の再現性と同一視しない。
EleutherAIの評価ハーネスはモデルのインターフェースと評価課題を分けている。アダプターと課題定義を独立させる参考として使える。提案する競技場も、この分離を保ちつつ環境固有の要件を記録したい。よく知られた構造の採用だけで、新ベンチマークが妥当になるわけではない。モデルインターフェース。
結果ごとに使える証跡を付ける
最小限の証跡には、課題版、モデル識別子、サンプリング設定、ツール権限、予算、審判版、採点規則を含める。許可された入力、実際の出力、客観結果、主観評価、既知の欠落を結び付ける。ハッシュは固定したファイルを識別できるが、内容の真実性や完全性を証明しない。
費用には分母が必要だ。失敗と許可済み再試行も含む全試行の支出を記録し、検証済み完了件数と対応させたい。完了がゼロなら、検証済み成果1件当たり費用は未定義になる。表示すべきなのは試行数と支出であり、安心させるゼロでも、失敗バッチの削除でもない。
時間にも境界がある。モデル応答待ち、ツール実行、再試行待機、人の介入を分ける。推論費を節約しても、担当者の午後を丸ごと使うエージェントは実務で魅力的とは限らない。介入の内容と所要時間を残し、観測できなかった値はUNKNOWNにする。
失敗記録にも同じ可視性が要る。タイムアウト、回答拒否、不正な形式の行動、基盤障害は意味が異なる。どのモデルが有利になるかを見る前に扱いを決める。除外理由と対象試行数を残さなければ、最も美しいグラフは最も厳しくデータを選別した結果かもしれない。
不一致を成果として扱う
交換可能な審判なら、結論が審判にどれほど依存するかを測れる。小さな固定回答ペア集合を、宣言した基準で採点するところから始めたい。回答順を反転し、可能ならモデル名を隠し、少なくとも二つの審判を比較する。参加者の出力は全過程で変えない。
この提案段階の実験では、対になった判定、順序に敏感な事例、審判間の相違を報告する。平均一致率だけでは重要な失敗分類が隠れる。事実の正しさ、表現、指示遵守、その他の基準のどこに相違が集まるかを示す。モデル全体の結論を出す前に分類を定義する。
人による裁定も、指示と不一致を持つ一つの観測だ。究極の真実として扱わない。小規模な盲検レビューは、審判が客観条件を満たさない回答を好む場合など、曖昧な基準の診断に役立つ。人の判断理由と、それを点検する証拠も残す。
提案の終了条件は控えめだ。第二の読者が再採点でき、客観結果が安定し、主観評価の差が見えるパッケージを一つ作る。本稿にその実験のスコアは存在しない。大規模な公開競争へ広げる前に、審判の仕組みが有用かを確かめたい。
開放には公開の境界が必要だ
私的な運用ログには、現実の失敗や複雑な仕事があり、研究素材として魅力がある。同時に、認証情報、個人情報、専有資料、信頼できない外部資料の指示が含まれ得る。公開には専用の出力パッケージを用意し、公開フィールドだけでも意味が通るようにする。事例が必要というだけで、私的アーカイブを公開してはならない。
最初は合成課題と合成の隠れた状態を使い、収録物を明記する設計がよい。採点出力をまとめる前に秘密情報と個人情報を除く。編集後も検証対象の仕組みが保たれる必要がある。難しい場合は制約を説明し、完全再現可能とは言わない。透明性は範囲を正確に示すほど強くなる。
ホールドアウトには別の境界がある。訓練・実演用の公開集合で課題を理解してもらい、別管理の保留集合で汎化を調べる。作成と評価の方針を記録し、正解は公開しない。開発中に課題へ繰り返し接したなら、その履歴を示し、より強い主張の前に測定設計を見直す。
NISTのAIリスク管理枠組みは、自主的なリスク管理の参考資料だ。この競技場を認証するものでも、公開権限を与えるものでもない。測定を利用場面とガバナンスに結び付け、単一スコアを普遍的な保証としない点が、ここでの参考になる。NISTの枠組み。
最小限で役立つ開かれた競技場
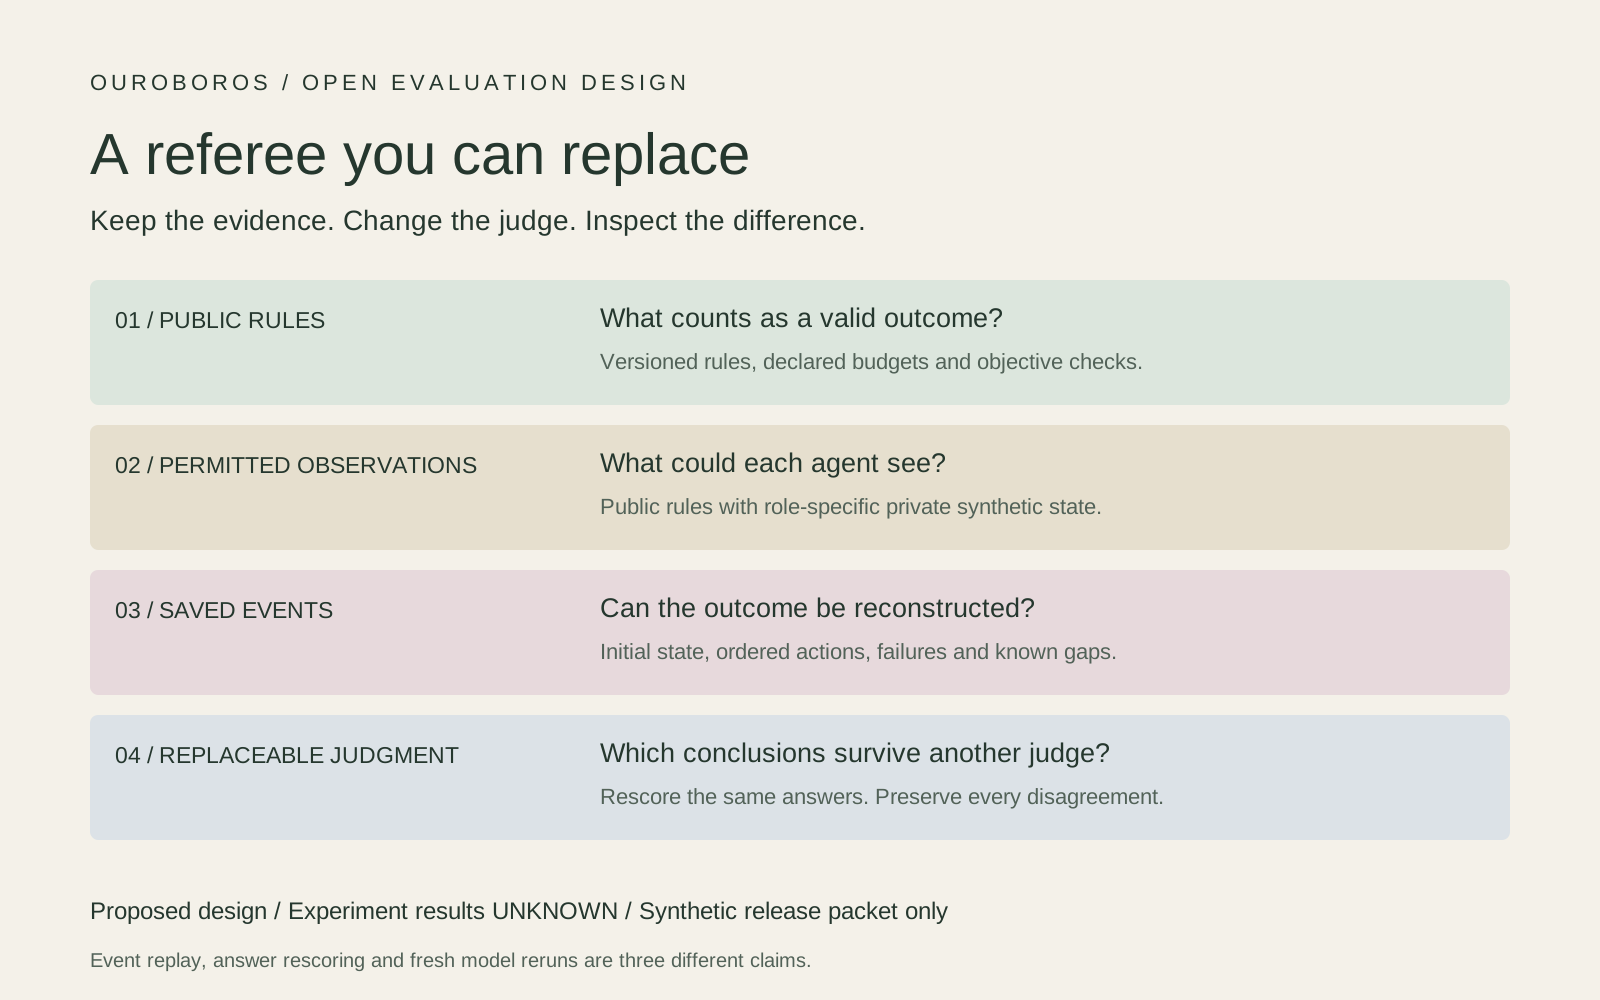
図は証拠の流れの提案であり、大会の測定結果ではない。公開規則が環境を制約し、権限が観察範囲を制約する。保存イベントは再生を支え、独立した採点層が解釈を交換可能にする。公開審査は共有できる合成記録を決める。各矢印には明確な役割がある。
初期パッケージには、限定した課題群、宣言済み資源予算、小さな固定事例集合で十分だ。参加モデルを動かす前に規則を固定する。失敗も保存する。第二の読者に客観結果の再構成と、別の審判による保存回答の再採点を依頼する。差異と再生失敗をパッケージとともに公表する。
受け入れ条件は、含まれる記録が実際の主張を支えることだ。全審判の一致、全エージェントの成功、汎用知能の予測を意味しない。冗長さを完全さと誤認する基準や、重要な観察を欠く「再現可能」な記録が見つかれば、それも有用な否定的結果だ。早期に欠陥を見つけることには価値がある。
監視の問いは四つ。別の読者が客観結果を再構成できるか。参加者を再実行せずに審判を交換できるか。公開証拠から順位変化を説明できるか。非公開、欠落、未検証の部分を識別できるか。実証された回答が増えて初めて、より強い主張が許される。
Model Olympicsは、自らの結論を丁寧な反証に開くことで、公共の研究資産になり得る。今日の成果物は設計、資料、図、保存用LinkedIn稿だ。最初の再生・再採点実験はREADYの提案であり、結果はUNKNOWN。次の意味ある節目は、第三者が独立に点検でき、設計上審判を取り外せる証拠パッケージである。
分類とキーワード
分類: 人工知能、評価、オープン研究、ガバナンス。
キーワード: Model Olympics、Dark Forest、LLM審判、決定論的判定、再生、評価者間の不一致、検証済み成果当たり費用、私有情報、ホールドアウト。
ハッシュタグ: #ModelOlympics #AIEvaluation #OpenResearch #AgenticAI #RobinOS