01 · AI Circularity Ledger
Astra升级阶梯
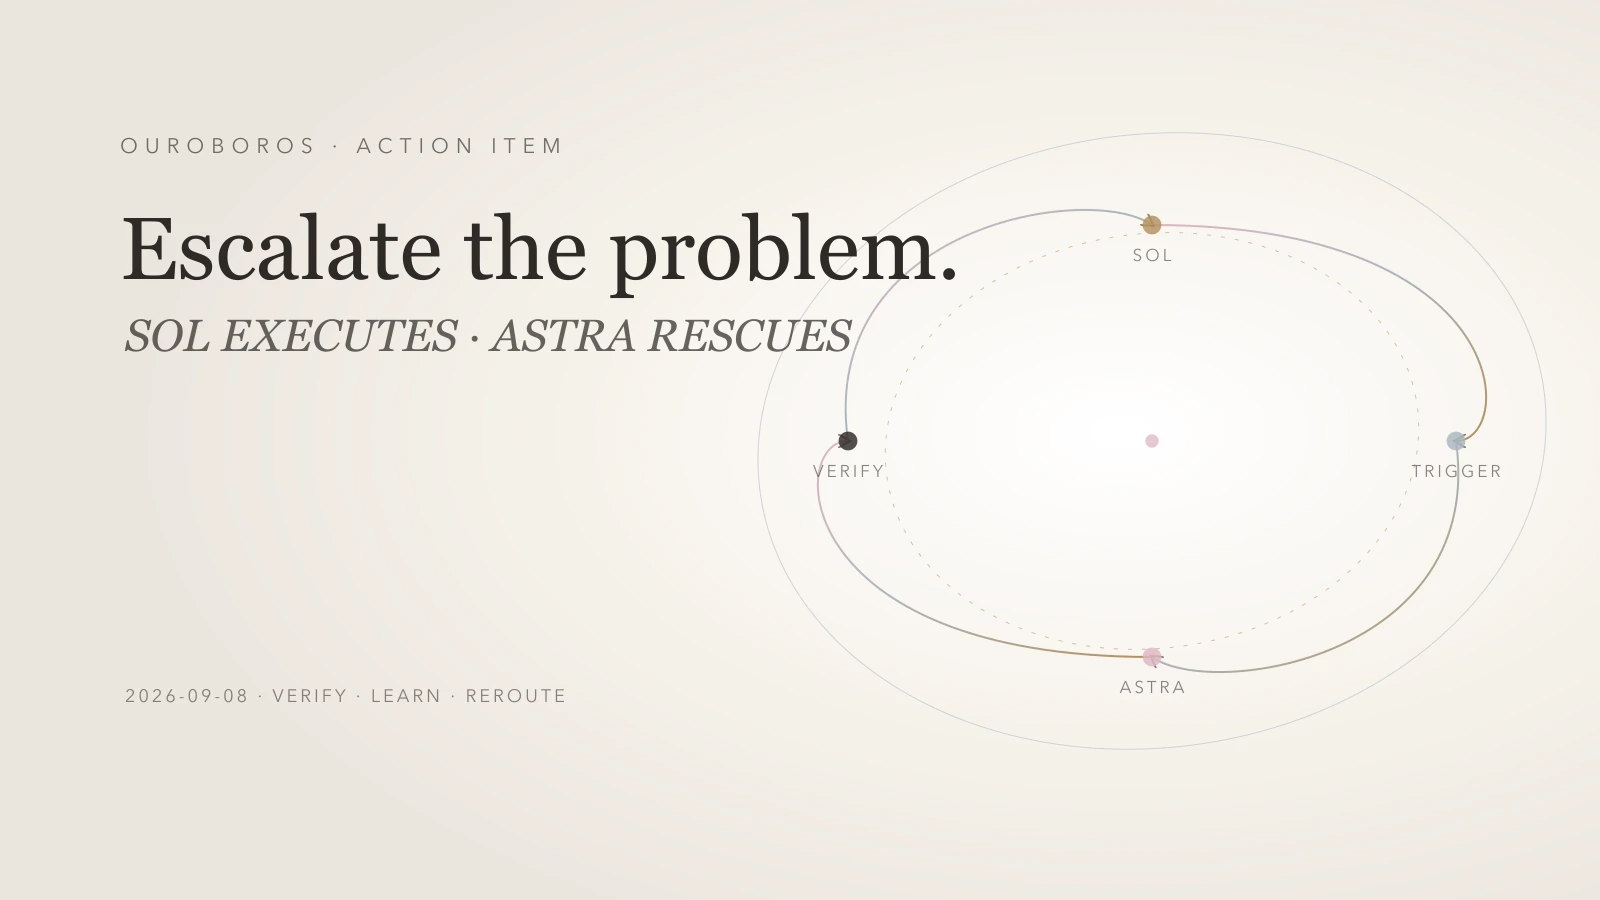
一个带着记分板的商业循环。
默认模型是产品选择
结论很直接:Astra应该先替代Robin成为升级台,而不是先替代Sol成为日常执行者。 Sol继续处理终点清楚、边界明确的任务;只有任务穿过既定失败门槛,且预期救援价值高于增量成本时,Astra才接手。最终由测试、回执和外部证据判定救援是否成功。
Codex CLI 0.153.4在未明确指定模型时把Astra设为内置默认。这是面向广泛用户的产品选择,却不足以成为一人公司的运营政策。Codex Changelog。OpenAI报告Astra相对Sol在Terminal‑Bench 4.0为57.9%对37.3%、AutomationBench为41.4%对18.1%、OSWorld为72.6%对65.7%;DeepSWE则只有74.1%对72.7%。这些是供应商评测,只能支持测试假设,不能替代RobinOS实绩。Astra发布与评测。
价格差同样明确:Astra每百万输入、输出Token分别为10美元和50美元,Sol为4美元和20美元,即对应单价均相差2.5倍。Astra模型页。Sol模型页。真实任务成本还取决于缓存、工具、重试、上下文及模型完成任务所需Token。
计算救援成本,而不是模型价格
Token价格是采购数据;每个验证结果的总成本才是经营数据。便宜模型若失败两次、破坏工作状态、耗掉一小时审查并把收尾留给Robin,最终并不便宜。高价模型若凭一个精确救援包一次修复难点,并通过外部验证,反而可能更经济。
每个任务至少记录总模型与工具成本、总耗时、Robin介入分钟、打断次数、修复循环及验证完成。还要记录恢复是否制造重复后果:重复发布、重复发送或覆盖新源,即使最终页面正确,也属于控制失败。
9月4日的Capability Is Not Authority区分了能力、授权、权限、执行和验证结果。升级只改变执行者及其上下文,不改变文件、目的地、权限和停止门禁。9月6日的Four Loop Test提出完成、恢复、记忆与改进;9月7日的Three Agent Workdays Still Need a Founder加入创始人注意力和空白十任务账本。今天的阶梯补上闭环中的交接规则。
本次发布不改变生产路由。20项任务记分表从空白开始,缺失观察一律保持UNKNOWN。
四种触发器值得升级
第一是架构歧义。Sol可以完成局部修改,却可能遗漏跨组件、Schema、部署规则和持久状态的合同。只有执行者已指出冲突与所需证据,仍无法形成一致改动边界时才升级。“任务很大”不是触发器;必须写明未解决接口,以及再试一次为何只会重复同一不确定性。
第二是同一验收门槛连续两次修复失败。第一次失败通常带来可行动信息,执行者应先诊断、修复。第二次仍失败才说明当前方法卡住。升级前要保存两次失败、命令、改动文件和最近正确状态。
第三是困难computer use或跨系统执行。OpenAI报告的OSWorld与AutomationBench差距,使其成为最清晰的Astra测试候选。确定性Shell修改仍留在日常通道;跨浏览器状态、本地文件和远端记录的脆弱流程,可以更早升级,以减少人工重建和重复副作用。
第四是静默错误代价很高的最终证据审查。这是审查通道,不是重写通道。Astra只接收成品、权限边界、预期证据与改动清单,检查矛盾、缺证、越界及回滚;确定性门禁在审查前后都要运行。
救援包就是控制面
Astra应收到结构化救援包,而非聊天摘要。救援包包括任务编号、精确目标、冻结终点、允许与禁止范围、确认工件、源版本、观察到的失败、已尝试修复、最近正确状态及下一项安全验证。
它不包含隐藏推理,也不写“Sol为什么失败”的自信故事。“SEO门禁因三个语言路由缺失而失败”是证据;“Sol不懂Astro”只是猜测。远端状态可能已改变时,第一步必须只读确认;外部副作用必须携带幂等证据。没有响应绝不等于远端动作失败。
救援后,Astra返回紧凑回执:改动文件、执行命令、通过测试、未解决事实、外部效果、回滚点及是否满足原终点。模型说明只能用于诊断,不能成为唯一证明。
OpenAI研究团队报告约3.1个Agent工作日对应一个人类工作日,同时超过一半成功的4至8小时任务仍需要人工介入。这是OpenAI内部数据,不可直接外推到RobinOS,却证明更多机器劳动与更少人类协调是两项不同结果。OpenAI研究工作流证据。
评测20项真实任务
在查看结果前冻结20项RobinOS真实任务,分为日常、跨文件架构、恢复和证据四类,每类五项。每项任务跨所有尝试保持同一编号,不能用“救援任务”另起分母。
记录由哪条通道闭环:Sol单独完成、Sol后Astra救援,或Sol后Astra证据复核。首要指标是每项分配任务的验证完成;第二是Robin介入分钟与打断次数;第三是包含全部失败、工具和审查的每个验证结果总成本。同时报告总耗时、修复循环、自动恢复和未授权改动。
负面证据也必须记录:Sol本可完成的错误升级、需要Robin介入的延迟升级、扩大改动面的救援、重放失败的经验。供应商benchmark可以设计实验,只有RobinOS回执才能改变RobinOS路由。
把救援变成路由证据
成功救援进入候选经验,携带来源、日期、任务类别、触发器、结果、成本和验证;第二个相似任务确认前只能保持试用状态。“Astra在Sol两次失败后修复这个跨文件Schema冲突”是观察;“Schema永远用Astra”是过度概括。
若某触发器持续预测成功救援,可对该类别更早升级;若Sol持续无干预过线,则继续留给Sol。每次路由变更都保存前一规则、促成变化的证据、生效日与复核门槛,使后续失败能够重放当时为何这样分配。
Murphy测试应覆盖诱人的错误触发、昂贵死循环、提出无关改动的救援、远端写入成功后的超时,以及单个故事形成的“经验”。正确系统会拒绝扩权、先查远端状态、限制修复次数,并让孤例保持试用。
决策规则
20项账本为空时,Sol保持日常执行者。只有命中四个触发器之一,并附完整救援包时才升级;接受前必须通过确定性验证或独立、有证据的人类判断,未知事实保持UNKNOWN。
当重复救援提高完成率,或减少的Robin介入足以覆盖全部增量成本,且权限、来源、恢复、回滚、防重与记忆质量没有重大退化时,才扩大Astra通道。样本和任务类别必须公开保留。
若任务终点移动、源版本不清、权限冲突、后果性动作后无法确认远端状态,或验证器受同一份未审查输出控制,应暂停升级并先修复状态。
Astra每次只凭一个验证救援赚取溢价。Sol保留日常通道,直到证据改变判断。Robin只处理真正需要Robin的决定。
类别与关键词
Categories: Artificial Intelligence; Agent Systems; Operating Models; One-Person Company
Keywords: GPT-6 Astra; GPT-5.6 Sol; escalation ladder; rescue packet; founder interruption; verified outcomes; cost per rescue; deterministic verification; model routing
Hashtags: #AI #AgentSystems #RobinOS #OnePersonCompany #VerifiedOutcomes